
Open WebUI 0.13.3: Coding-Agenten im Chat – wer kontrolliert den Rechner?
Open WebUI verknüpft Chat, lokale Coding-Agenten und geplante Automationen. Der Nutzen ist konkret – die Rechte für Rechner, Dateien und Tools müssen es ebenso sein.
Version 0.13.3 bringt Coding-Agenten in geplante Läufe. Das löst nicht automatisch Rechte-, Audit- oder Verfügbarkeitsfragen.
1. Was am 8. November wirklich neu wurde
In Version 0.13.1 erscheinen vorhandene Coding-Agenten in Open WebUI als auswählbare Modelle, wenn der verwendete Open Terminal Agenten bereitstellt. Nutzer können Agenten-Chats beziehungsweise Sprachinteraktionen starten, Reasoning-Effort und Service-Tier auswählen und Tool-Anfragen im Chat genehmigen. Ein Agent pro Unterhaltung ist vorgesehen; normale Chatfunktionen wie regenerieren oder bearbeitet erneut absenden sind für diese Agentengespräche eingeschränkt. Geht der Terminalzugang verloren, wechselt die Oberfläche auf das Standardmodell zurück.
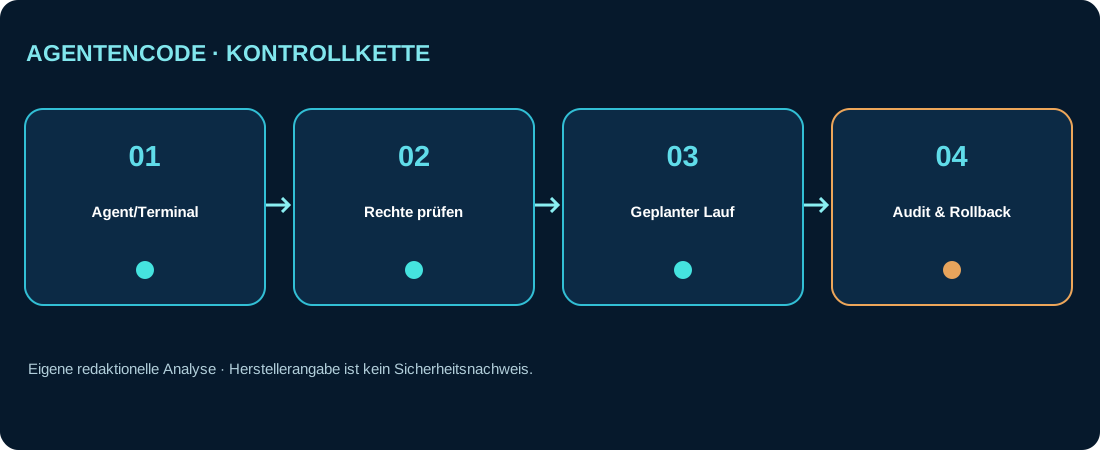
Mit 0.13.3 kommt der nächste Schritt: Der Automationseditor erlaubt die Auswahl eines Terminals, eines Arbeitsordners und eines dort verfügbaren Coding-Agenten. Ein geplanter Lauf verwendet diese gespeicherte Kombination und prüft, ob Terminal und Agent beim Start erreichbar sind. Die Ergebnisse laufen in einen Chat zurück. Das ist eine Produktfunktion für wiederkehrende Tätigkeiten – kein Nachweis, dass jede Agenten-Aufgabe dauerhaft zuverlässig oder ohne Aufsicht ausgeführt wird.
2. Tether verändert die Sicherheitsgrenze
Die neue Desktop-Begleit-App Tether verbindet laut Hersteller macOS, Windows oder Linux mit Open WebUI. Die Verbindung wird vom Computer nach außen aufgebaut; dafür sollen keine eingehenden Ports geöffnet werden müssen. Terminalausgaben können nach Verbindungsunterbrechungen fortgesetzt werden. Damit kann ein Agent aus einer Browseroberfläche heraus mit Dateien, Repositories und Tools des eigenen Geräts arbeiten, sofern er dafür konfiguriert und autorisiert ist.
Für Teams ist das zugleich Chance und Risikowechsel: Aus einem Sprachmodell, das über Dateien spricht, kann ein System werden, das tatsächlich Dateien und Kommandos auf einem produktiven Rechner verändert. Gerätebindung ist keine Berechtigungsfreigabe für sämtliche Ordner. Die Vertrauensgrenze muss auf Dateisystem, Prozess, Netzwerk, Geheimnissen und Verantwortlichkeit konkret festgelegt werden.
3. Automatische Tool-Freigabe bleibt ein separates Experiment
Version 0.13.1 ergänzt neben „Full access“ und „Ask for approval“ den optionalen Modus Auto. Er ist standardmäßig deaktiviert. Ein Prüfmodell bewertet Tool-Aufrufe. Nach Herstellerangaben sieht die Bewertung Werkzeugname, Argumente und jüngste Nachrichten; nicht bewertbare Aufrufe wegen Fehlern, Zeitlimit oder zu viel Kontext gehen zur menschlichen Freigabe.
Unsere Einordnung: Ein solches LLM-Gate kann die Zahl manueller Dialoge reduzieren, ist aber kein Ersatz für eine technische Zugriffskontrolle. Vor dem Pilot müssen Teams klären, welche Inhalte an die Bewertungs-API gelangen, welche Schreibrechte das Tool tatsächlich besitzt und wie sich fehlerhafte Freigaben nachweisen oder rückgängig machen lassen.
4. AgentenCode-Freigabematrix
| Neue Fähigkeit | Herstellerstatus / Scope | Vor produktiver Nutzung prüfen |
|---|---|---|
| Codex, Claude Code, Pi im Modellwähler | 0.13.1, nur auf geeignetem Open Terminal | Installierter Agent, Modellzugang, Terminalgrenze, Tool-Zustimmungen |
| Tether-Desktop-Verbindung | 0.13.1, Desktop-App für macOS/Windows/Linux | Gerätetokens, lokale Ordner, Repository-Berechtigungen, Wiederverbindung |
| Agenten in Automationen | 0.13.3, gespeichertes Terminal und Arbeitsverzeichnis | Laufidentität, Trigger, Ausfall bei Offline-Gerät, Ergebnisse, Abbruch/Retry |
| Auto-Tool-Berechtigungen | Optional, standardmäßig aus | Scoring-API, Datenübermittlung, Policy-Grenzen, Auditpfad |
Entscheidung: Ein Leserechte-Pilot mit nicht-produktivem Repository ist angemessen. Automatisiertes Schreiben, Paketinstallation, Zugriff auf Secrets und produktive Deployments erfordern explizite gesonderte Genehmigungen, Scope-Limits und rückholbare Änderungen.
5. Drei kontrollierte Pilotaufgaben
- Lesen: In einem getrennten Testordner einen Repository-Überblick und eine Liste veralteter Abhängigkeiten erstellen, ohne Dateien zu verändern.
- Vorschlagen: Einen vorgeschlagenen Patch ausschließlich als Diff erzeugen. Ein Mensch prüft Imports, Tests, Seiteneffekte und Quellen.
- Geplant prüfen: Eine Automation in einem isolierten Verzeichnis ausführen, bei Offline-Terminal scheitern lassen und das Ergebnis inklusive Zeitstempel dokumentieren. Erst danach begrenzte Schreibfreigaben erwägen.
Entscheidend ist, Reichweite (welche Ressource darf der Agent sehen?) und Aktion (was darf er ändern?) getrennt zu testen. Ein grüner Testlauf belegt keine dauerhaft sichere Policy.
6. Verfügbarkeit, Kosten und Grenzen
Das Projekt veröffentlichte 0.13.1 und 0.13.3 als GitHub-Releases am 8. November. Aus den Release Notes folgt nicht, dass Tether, alle Modellanbieter, Rechenleistung oder Agenten-Abonnements überall kostenlos verfügbar sind. Eine Preis- oder Nutzungszusage für Claude Code, Codex oder andere integrierte Anbieter wäre unbelegt. Die Funktionen hängen von Installationsart, Terminal-Integration und Anbieterzugängen ab. Open WebUI gibt für diese Agenten-Versionen Einschränkungen bei der Bearbeitung und Wiederholung von Chats an.
7. FAQ
Sind Coding-Agenten jetzt in jedem Open-WebUI-Chat verfügbar? Nein. Die offizielle Beschreibung setzt voraus, dass der verbundene Open Terminal entsprechende Agenten bereitstellt.
Kann eine geplante Automation ohne laufenden Computer arbeiten? Das Release beschreibt gespeicherte Terminal-/Ordnerbindungen und eine Verfügbarkeitsprüfung. Es belegt keine vom Gerät unabhängige Ausführungsgarantie.
Ist „Auto“ mit „sicher“ gleichzusetzen? Nein. Die Freigabe durch ein Prüfmodell ist eine zusätzliche Entscheidungsebene, kein nachgewiesener Sandbox- oder Berechtigungsersatz.
8. Primärquellen und Methodik
- Open WebUI v0.13.1 – offizielle Release Notes, 8. November 2026
- Open WebUI v0.13.3 – offizielle Release Notes, 8. November 2026
- Open-WebUI-Projekt
Methodik: Aussagen zu Funktionen und Release-Status stammen aus den Maintainer-Notizen; die Freigabematrix, Risiken und Pilotabfolge sind eigenständige AgentenCode-Redaktionsanalyse. Keine unabhängige Funktionsmessung, keine Sicherheitszertifizierung, keine Erhebung zu Preis/Region.