
OpenAI plant ein gemeinsames KI-Trainingssignal – warum Website-Betreiber nicht vorschnell reagieren sollten
Das Verhältnis zwischen Künstlicher Intelligenz und dem offenen Web verändert sich. OpenAI will künftig ein gemeinsames robots.txt-Signal beachten, mit dem Website-Betreiber ihre Wünsche zum KI-Training ausdrücken. Die am 30. Oktober 2026 angekündigte Initiative betrifft Verlage, Unternehmen und Content-Ersteller – aber die Umsetzung steht noch aus, und die technische Grundlage ist kein verabschiedeter Internetstandard.
OpenAI kündigt ein gemeinsames robots.txt-Signal an. Es ist noch nicht implementiert und kein verabschiedeter IETF-Standard. Die AgentenCode-Matrix.
Quellenlage und Grenzen
- Primärquellen
Offizielle Meldung vom 30.10.2026. Originalquelle.
- Status und Testgrenzen
Implementierung für kommende Monate angekündigt; kein ratifizierter IETF-Standard. Keine unabhängigen Produkttests.
Was OpenAI wirklich zugesagt hat
In seiner Ankündigung vom 30. Oktober erklärt OpenAI, das gemeinsame Signal in robots.txt künftig zu respektieren. Es soll Betreibern erleichtern, eine Trainingspräferenz gegenüber mehreren teilnehmenden Anbietern auszudrücken, statt jeden Bot einzeln zu adressieren. Der entscheidende Satz steht bei der Verfügbarkeit: OpenAI strebt eine Umsetzung in den kommenden Monaten an und will technische Einzelheiten später veröffentlichen. Bestehende Steuerungsmöglichkeiten für die eigenen Crawler sollen weiterhin gelten.
Ein Internet-Draft ist noch kein IETF-Standard
Der verlinkte Entwurf vom 30. Oktober beschreibt den Token __usage_ai-training in einer normalen robots.txt-User-Agent-Gruppe. Im Beispiel signalisiert User-agent: __usage_ai-training zusammen mit Disallow: / eine Präferenz gegen KI-Training. Der IETF-Datentracker stellt jedoch ausdrücklich klar: Es handelt sich um einen individuellen Internet-Draft ohne formales IETF-Endorsement. Die Regeln können sich ändern. Eine Präferenz ist außerdem kein technischer Schutz gegen das Kopieren von Inhalten.
Eigene Analyse: Training, Crawling und KI-Suche unterscheiden
Unsere wichtigste Erkenntnis aus Originalmeldung und Entwurf ist die Trennung dreier Vorgänge. Modelltraining verändert gelernte Modellparameter; Crawling ruft Inhalte automatisiert ab; KI-Suche oder Browser-Agenten können Seiten für eine aktuelle Anfrage laden. Der vorgeschlagene Trainings-Token ist laut Entwurf ausdrücklich keine neue Crawling-Direktive. Wer Trainingsnutzung begrenzen möchte, muss deshalb nicht automatisch denselben Wunsch zur Auffindbarkeit in KI-Suche haben. Umgekehrt bedeutet Zulassung zum Training nicht, dass eine Seite in Antworten korrekt zitiert wird.
Unsere Entscheidungs- und Geltungsbereichsmatrix
Die folgende Tabelle übersetzt die Quellen in sieben konkrete Betreiberentscheidungen. Sie unterscheidet nachweisbaren Dokumentstatus von Empfehlungen der AgentenCode-Redaktion. Vor allem die Trennung von Zweck, Zugriff und Recht soll helfen, vorschnelle Komplettsperren zu vermeiden. Wir haben keine unabhängige Messung zur Einhaltung des Signals, zu Google-Sichtbarkeit oder KI-Zitierungen durchgeführt. Die Tabelle enthält auch keine Rechtsberatung.
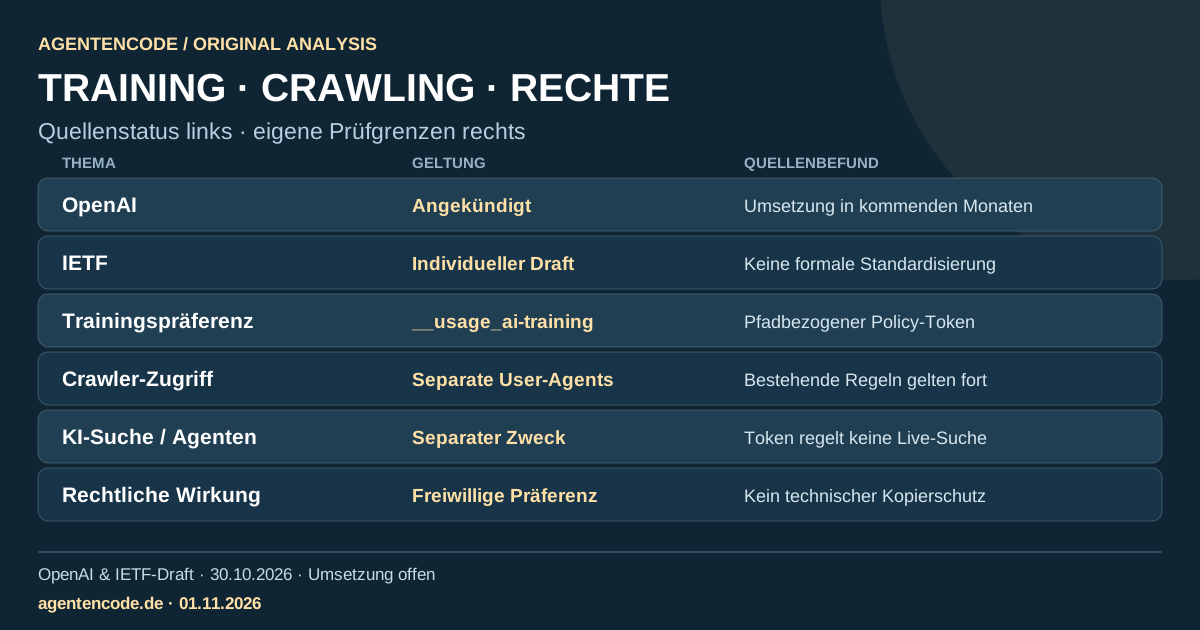
| Thema | Geltung | Beleg | Empfehlung |
|---|---|---|---|
| OpenAI | Angekündigt | Umsetzung in kommenden Monaten | Nicht als heute aktiv darstellen |
| IETF | Individueller Draft | Keine formale Standardisierung | Version nachverfolgen |
| Trainingspräferenz | __usage_ai-training | Pfadbezogener Policy-Token | Wünsche für Inhalte getrennt festlegen |
| Crawler-Zugriff | Separate User-Agents | Bestehende Regeln gelten fort | Sperren nicht ungeprüft ändern |
| KI-Suche / Agenten | Separater Zweck | Token regelt keine Live-Suche | Auffindbarkeit getrennt bewerten |
| Rechtliche Wirkung | Freiwillige Präferenz | Kein technischer Kopierschutz | Rechts- und Lizenzfragen prüfen |
| Einführung | Kein fixer Termin | Umsetzung noch unbelegt | Später Logs und Regeln testen |
Was Betreiber heute tun können
- Bestandsaufnahme: In der robots.txt vorhandene Bot-Regeln erfassen und mit den bereits dokumentierten OpenAI-Crawler-Einstellungen abgleichen.
- Politik definieren: Gemeinsam mit Redaktion, Recht und Technik entscheiden, für welche Inhalte Training erwünscht oder unerwünscht ist und wie sich das von normalem Crawling unterscheidet.
- Nach Umsetzung prüfen: Den Entwurf und OpenAIs spätere Einführung verfolgen; Änderungen versionieren und mit echten Betreiberlogs validieren, statt eine Ankündigung als wirksamen Schutz auszugeben.
Warum die Meldung jeden KI-Nutzer betrifft
Die Debatte entscheidet darüber mit, unter welchen Bedingungen Informationen im Netz trainiert, gefunden und in KI-Assistenten genutzt werden. Für redaktionelle Quellen ist das eine neue Governance-Frage, nicht bloß eine SEO-Einstellung. AgentenCode trennt deshalb Quellenzugänglichkeit, überprüfbare Evidenz und Produktbehauptungen. Die gemeinsame Trainingspräferenz kann einen Fortschritt darstellen, sollte aber nicht mit einem rechtlich verbindlichen Standard, einem allgemeinen Crawling-Verbot oder garantierter KI-Sichtbarkeit verwechselt werden.
Originalquellen
Häufige Fragen
Funktioniert das neue Signal heute schon bei OpenAI?
OpenAI hat am 30. Oktober eine künftige Umsetzung angekündigt; eine aktuelle Live-Einhaltung ist dadurch nicht belegt.
Sperrt das Signal automatisch KI-Suche?
Nein. Der Internet-Draft trennt Trainingspräferenzen ausdrücklich von Crawler-Regeln.
Ist der Entwurf schon ein offizieller Standard?
Nein. Der IETF-Datentracker bezeichnet ihn als individuellen Internet-Draft ohne formale Anerkennung.