
Anthropic: KI-Agenten lernen im Schlaf – was Dreaming wirklich bringt
Ein KI-Agent, der sich alles merkt, ist noch lange kein guter Agent. Zu viele unüberprüfte Notizen können wichtige Regeln verbergen, veralten oder selbst zum Ausgangspunkt falscher Entscheidungen werden. Anthropic beschreibt jetzt ein mehrstufiges Gedächtnissystem für Claude: Rohprotokolle bleiben durchsuchbar, wichtige Beobachtungen werden als Notizen gespeichert, vernetzte Wissens-Wikis erleichtern die Orientierung – und ein nachgelagerter Prozess namens Dreaming kann diese Ebenen nachträglich prüfen und pflegen.
Gedächtnis ist nicht das Kontextfenster
Anthropic definiert Agentengedächtnis als Wissen aus vergangenen Interaktionen und Aufgaben, das zwischen Sitzungen erhalten bleibt und später wieder gelesen werden kann. Ein langes Kontextfenster oder eine komprimierte Konversation ist damit nicht automatisch dasselbe. Die zentrale Architektur unterscheidet vier Ebenen: unveränderte Sitzungsprotokolle, konkrete Erinnerungsnotizen, strukturierte Repräsentationen wie Wikis und einen kleinen Ausschnitt vorab in neue Sitzungen geladenen Kontexts.
AgentenCode-Analyse: Diese Trennung ist nicht dekorativ. Sie ermöglicht Provenienz: Eine vermeintliche Regel lässt sich gegen das ursprüngliche Protokoll prüfen. Ohne diesen Rückweg wird aus einem Irrtum schnell ein scheinbar gesichertes Stück „Erfahrung“. Dass eine Notiz vom Agenten stammt, macht sie nicht wahr.
Ein Benchmark, in dem Erinnerung tatsächlich hilft
Anthropic untersucht eine Datenbank-Aufgabe aus Continual Learning Bench (CL-Bench) 1.0. Die Modelle beantworten aufeinanderfolgende Fragen, erhalten nach jeder Frage eine Rückmeldung und können Erkenntnisse in ein verzeichnisbasiertes Gedächtnis schreiben. Jede neue Frage beginnt in einer frischen Sitzung; die gespeicherten Dateien sind die Verbindung zwischen den Sitzungen.
| Modell | Ohne gespeichertes Gedächtnis | Mit Gedächtnis | Einordnung |
|---|---|---|---|
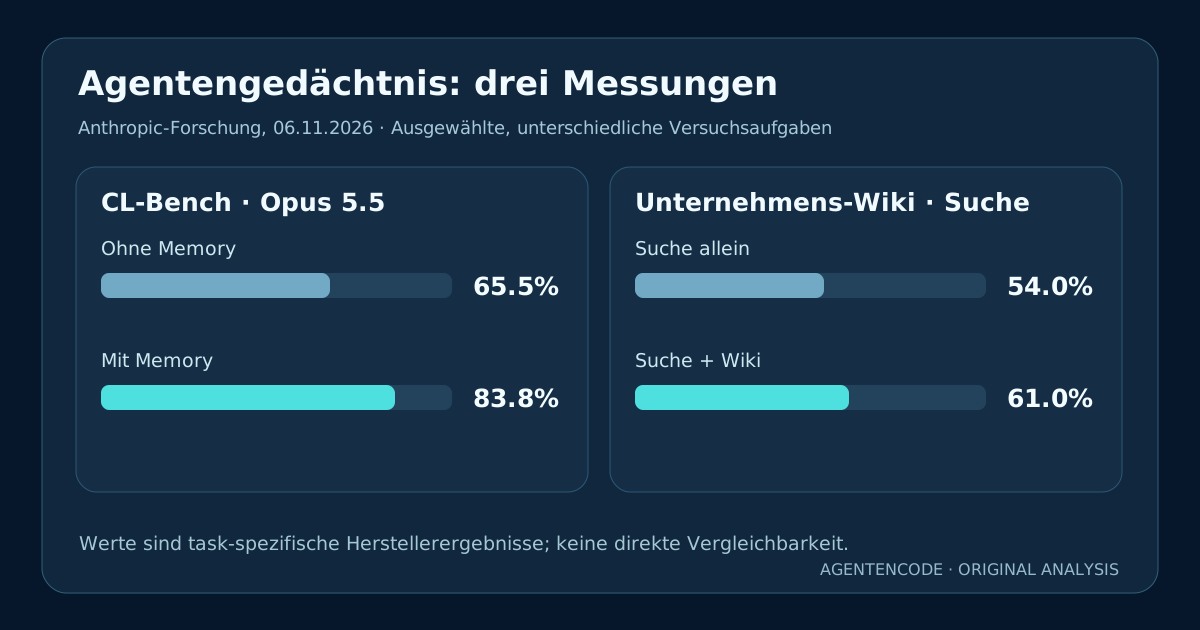
| Claude Opus 5.5 | 0,655 | 0,838 | +0,183 Rubrikpunkte |
| Claude Sonnet 5.5 | 0,644 | 0,833 | +0,189 Rubrikpunkte |
| Claude Opus 5 | 0,564 | 0,828 | +0,264 Rubrikpunkte |
| Claude Sonnet 4.6 | 0,330 | 0,364 | +0,034 Rubrikpunkte |
Die Werte sind Anteile am mittleren Bewertungsscore der gezeigten Aufgabe, nicht der Prozentsatz vollständig autonom bewältigter Unternehmensprojekte. Der Unterschied zwischen Modellen zeigt außerdem: Ein Ordner namens „Memory“ schafft noch kein funktionierendes Lernen. Stärkere Modelle schreiben eher überprüfte Regeln samt Begründung und vermeiden es, bloße Vermutungen als Tatsachen festzuhalten.
Das überraschende Problem: Zu viele Erinnerungen machen Agenten schlechter
In einer langen Pokémon-Red-Aufgabe verglich Anthropic einzelne Durchläufe zweier Modelle nach ungefähr 10.000 Schritten. Claude Sonnet 3.7 hatte 413 Dateien in 225 Ordnern angelegt und einen Orden erreicht. Claude Fable 5 hatte dagegen neun Dateien in zwei Ordnern plus eine globale Datei erstellt und vier Orden erreicht.
Daraus lässt sich kein allgemeiner kausaler Leistungsvorsprung aus genau diesen Dateizahlen ableiten: Es sind einzelne, unterschiedliche Modellläufe. Sie illustrieren aber ein operatives Problem: Wer jede Begegnung und jeden Zustand ablegt, erzeugt Suchkosten und veraltetes Wissen. Zeitweise verwaltete das ältere Modell seine Notizen, statt die eigentliche Spielaufgabe fortzusetzen.
Redaktionelle Schlussfolgerung: Memory-Qualität braucht eigene Kennzahlen für Relevanz, Aktualität und Zeitverbrauch. „Anzahl gespeicherter Fakten“ ist eher eine mögliche Kosten- als eine Qualitätsmetrik.
Was „Dreaming“ wirklich bedeutet
Dreaming ist keine Änderung der Modellgewichte und keine besondere Bewusstseinsfunktion. In Anthropic' Darstellung laufen zusätzliche Verarbeitungsschritte über alte Sitzungsprotokolle und Gedächtnisdateien. Dabei kann Claude Fehler korrigieren, doppelte Notizen zusammenführen, Verweise reparieren, neue Wikiseiten schaffen oder wenige besonders wichtige Hinweise für die nächste Sitzung auswählen.
Ein anschauliches Experiment: Beim Pokémon-Spiel hatte Claude einen Orientierungspunkt am falschen Ende einer Höhle vermerkt. Beim späteren Dreaming-Abgleich fiel der Widerspruch zum ursprünglichen Protokoll auf. Mit korrigierter Notiz fand der Agent den Weg weiter; in den beschriebenen Vergleichsläufen ohne Korrektur gelang das nicht. Das ist ein gezieltes Demonstrationsbeispiel, kein Nachweis, dass Dreaming grundsätzlich alle Gedächtnisfehler beseitigt.
Wikis helfen besonders, wenn Wissen verteilt ist
Anthropic testete ein internes Korpus von etwa 350.000 Dateien und 420 Millionen Tokens. Ein Agent baute über bis zu 128 Sitzungen ein vernetztes Wiki, das zusätzlich zur normalen Suche genutzt werden konnte. Auf einem Satz von 25 Fragen berichtete Anthropic für den kombinierten Zugriff 54 Prozent mit frühem Wiki versus 61 Prozent mit weiter aufgebautem Wiki; eine Suche ohne Wiki erzielte in diesem Vergleich 53 Prozent. Der Anbieter nennt zudem ungefähr 20.000 eingesparte Tokens pro Frage.
In einer anderen Aufgabe stieg die Bewertung mehrteiliger Fragen zu einem Unternehmenskauf mit Wiki-Unterstützung laut Anthropic von 73 auf 87 Prozent. Bei einfacheren, direkt auffindbaren Vertragsfragen brachte das Wiki dagegen keinen klaren Vorteil – und einmal wurde das Wiki sogar größer als die Quelldokumente.
Bewertung: Der Nutzen entsteht, wenn verschiedene Quellen kombiniert, verknüpft und interpretiert werden müssen. Für eine eindeutige Dokumentstelle kann eine gute Suchfunktion günstiger und weniger fehleranfällig sein.
Die gefährlichste Stelle: Gleichzeitige Änderungen am Gedächtnis
Mehrere Agenten schrieben in einem Anthropic-Test in dieselbe zentrale Vertragstabelle. Dabei gingen Angaben verloren; nur 41 von 57 bewerteten Vertragsfakten blieben zuverlässig im Wiki erhalten. Nach einer neuen Arbeitsaufteilung – ein Dokument beziehungsweise eine Seite je Agent, mit originalgetreuen Vertragsauszügen – waren 57 von 57 Fakten vorhanden.
Das ist kein „besseres Prompting“ allein, sondern ein Problem von Schreibkonkurrenz, Zuständigkeit und Datenmodell. Für reale Agentensysteme gehören Konfliktvermeidung, Versionskontrolle, Quellenbelege, Freigabestatus und Rückrollbarkeit zur Gedächtnisarchitektur. Der Bericht belegt die Verbesserung in diesem Test, nicht eine globale Garantie für fehlerfreien Mehragentenbetrieb.
Unsere Evidenz- und Freigabematrix
| Gedächtnisebene | Nutzen | Hauptrisiko | Mindestkontrolle |
|---|---|---|---|
| Unverändertes Protokoll | Quelle für spätere Prüfung | Sensible Inhalte/Retention | Zugriff, Lösch- und Aufbewahrungsregeln |
| Agentennotiz | Schnelle Wiederverwendung | Falsche oder veraltete Regel | Quelle, Zeitstempel, Verifikationsstatus |
| Verlinktes Wiki | Kombination verteilter Befunde | Halluzinierte Links, Doppelungen | Link-Checks, Verweis auf Originalquelle |
| Automatische Verdichtung | Weniger irrelevanter Kontext | Wiederholte Irrtümer | Audit-Trail und Gegenprüfung |
| Vorab geladene Memory | Schneller Start | Falsche Regel in jeder Sitzung | Sehr kleine, überprüfte Menge |
| Paralleles Schreiben | Schneller Wissensaufbau | Überschreiben anderer Agenten | Eigentümer, Versionierung und Merge-Gate |
Diese Matrix ist eine eigene AgentenCode-Handlungsempfehlung. Anthropic liefert die Fallstudien, nicht die Zertifizierung dieser Betriebsregeln.
Ein sinnvoller Praxistest für Unternehmen
Ein seriöser Pilot verwendet dieselben wiederkehrenden Aufgaben in drei Varianten: ohne persistente Notizen, mit einfachen quellverlinkten Notizen und mit Notizen plus periodischer Überprüfung/Wiki. Gemessen werden Trefferquote auf neuen Aufgaben, falsche Erinnerungen, Korrekturzeit, Token- und Compute-Kosten, Schreibkonflikte und die tatsächlich nachprüfbare Herkunft einer Entscheidung. Besonders aussagekräftig sind Aufgaben, in denen sich Daten nachträglich ändern – denn genau dort wird altes Agentenwissen riskant.
Zudem sollten Betroffene nachvollziehen können, was gespeichert wurde und wie eine falsche Erinnerung korrigiert oder gelöscht wird. Das ist eine betriebliche und datenschutzrechtliche Anforderung, nicht direkt ein Resultat der Anthropic-Benchmarks.
FAQ
Ist Dreaming ein Training der Modellgewichte? Nein. Es bezeichnet hier nachgelagerte Verarbeitung von Transkripten und Erinnerungsdateien, nicht ein neues Parametertraining des Modells.
Hat Claude dadurch generell 83,8 Prozent Erfolgsquote? Nein. 0,838 ist der mittlere Score von Opus 5.5 in einer speziellen CL-Bench-Datenbankaufgabe mit Gedächtnis.
Wann lohnt sich ein Wiki gegenüber Suche? Vor allem bei Aufgaben, die Wissen über viele Dokumente hinweg verbinden müssen. Für einfache Faktenabfragen kann Suche allein reichen.
Kann automatisches Dreaming schlechte Erinnerungen immer reparieren? Nein. Der Bericht enthält Demonstrationen und Grenzen, aber keine allgemein gültige Garantie.
Warum sind parallele Agenten ein Risiko? Wenn sie gleichzeitig dieselbe Gedächtnisdatei verändern, können geprüfte Informationen überschrieben oder ausgelassen werden.
Fazit: Erinnerung braucht eine Beweisführung
Die spannende Entwicklung ist nicht „Claude merkt sich mehr“. Sie ist die Trennung von Originalereignis, vorläufiger Notiz, geprüftem Wissen und sicherer Wiederverwendung. Je länger Agenten eigenständig arbeiten, desto wichtiger wird diese Unterscheidung. Ein gutes Agentengedächtnis ist kein maximal gefülltes Archiv, sondern eine überprüfbare, aktualisierbare Entscheidungsgrundlage.
Quelle und Grenzen
- Anthropic Engineering: The components of agent memory, 06.11.2026
- Alle Benchmarkwerte und Beispiele stammen aus der Herstellerforschung, wie dort beschrieben. Die Governance-Matrix und praktischen Pilotschritte sind eigene Redaktionsempfehlungen. AgentenCode hat keinen Benchmark nachgerechnet, keine persönlichen Datenspeicher inspiziert und keine produktiven Speicher- oder Sicherheitsgarantien geprüft.
Primärquelle und Prüfgrenzen
Herstellerangaben und eigene Analyse sind gekennzeichnet. Keine unabhängige Replikation von Benchmark-, Zugriffs- oder Sicherheitsbehauptungen.