
Claude Fable 5.2 und Mythos 5.2: Was 1.000 KI-Agenten wirklich zeigen
1.000 KI-Agenten, ein formaler Mathematikbeweis und ein startfähiges Betriebssystem: Die neue Fable-Generation zeigt, wie weit sich komplexe Aufgaben auf Agententeams verteilen lassen. Doch Ergebnisse aus Forschungsaufbauten sind noch keine Garantie für verlässliche Unternehmensautomatisierung.
Laut Anthropic koordinierte Fable 5.2 mehr als 1.000 Subagenten über acht Tage beim Bau eines Betriebssystem-Prototyps. Ein 1.000-Agenten-Team formalisierte Fermats letzten Satz in Lean in 30 Stunden. Entscheidend sind der Versuchsaufbau, die Verifikationsmöglichkeiten und die Zugangsgrenzen – nicht allein die Agentenzahl.
Quellenlage und Grenzen
Datiert auf 2026-11-09: Anthropic Originalankündigung. Produkt-, Test- und Verfügbarkeitsaussagen stammen vom Anbieter.
Keine eigene Produktprüfung, keine reproduzierte Laufzeitmessung und kein unabhängiges Sicherheits- oder Wirksamkeits-Audit. Unsere Matrix ist redaktionelle Ableitung.
Was Anthropic am 9. November tatsächlich vorgestellt hat
Anthropic hat Claude Fable 5.2 und Claude Mythos 5.2 am 9. November 2026 angekündigt. Beide verwenden laut Anbieter denselben zugrunde liegenden Modellkern. Fable ist die breit verfügbare Variante mit Schutzmechanismen für risikoreiche Cyber- und Biologieaufgaben; Mythos richtet sich über Verifizierungsprogramme an qualifizierte Organisationen in diesen Bereichen. Die beiden Produktbezeichnungen stehen also nicht für zwei beliebig austauschbare öffentliche API-Angebote.
Fable 5.2 soll bei Coding, Schlussfolgern, Bildverarbeitung und langlaufenden technischen Arbeiten leistungsfähiger sein als Fable 5.1. Anthropic berichtet zugleich von bis zu 30 Prozent höherer Ausgabegeschwindigkeit im Vergleich zur jeweiligen 5.1-Version. Diese Angabe ist eine herstellerseitige Leistungsbehauptung mit konkretem Vergleich, kein eigener AgentenCode-Geschwindigkeitstest.
1.000 Subagenten: Was der Betriebssystem-Versuch beweist
Ein Anthropic-Ingenieur ließ Fable 5.2 mit einem leeren Projektordner einen Betriebssystem-Prototyp entwickeln. Das Modell koordinierte laut Veröffentlichung mehr als 1.000 Subagenten, die acht Tage lang Code schrieben, testeten und überprüften. Das Ergebnis konnte nach Darstellung des Unternehmens auf einem Laptop starten und umfasste unter anderem Dateispeicherung, Treiber, Fensterdarstellung und Login.
Gerade die Kombination aus Planung, Delegation, Tests und Überprüfung ist agentenrelevant. Eine hohe Agentenzahl allein ist jedoch keine Produktkennzahl: Ohne Angaben zu Fehlversuchen, Compute-Budget, menschlichen Eingriffen und stabiler Wiederholbarkeit ist der Versuch nicht direkt als Wirtschaftlichkeitsnachweis auf Unternehmensprojekte übertragbar. Die Veröffentlichung zeigt einen spezifischen Prototyp, kein allgemeines Betriebssystem für den produktiven Einsatz.
Fermats letzter Satz: Warum 30 Stunden nicht einfach „KI löst Mathematik“ bedeuten
Ein zweiter Versuch beschäftigte sich nicht mit dem Entdecken eines bislang ungelösten mathematischen Problems, sondern mit der formalen Übersetzung eines bekannten Beweises in Lean. Rund 1.000 Fable-5.2-Agenten formalisierten Fermats letzten Satz nach Anthropic in 30 Stunden bei minimaler menschlicher Intervention. Sie erhielten eine Liste von Zwischentheoremen, konnten die Arbeit aber weitgehend selbst koordinieren.
Zum Vergleich beschreibt Anthropic eine frühere Formalisierung mit elf Tagen Laufzeit und menschlicher Anleitung. In einem weiteren Einzelvergleich mit derselben 1.000-Agenten-Umgebung erreichte Opus 5.5 nach 18 Stunden nur 26 Prozent der formalen Aufgabe und kam bis Stunde 30 kaum weiter. Das sind einzelne Forschungsdurchläufe; sie belegen weder eine allgemeine Erfolgsquote noch die Lösung eines neuen mathematischen Satzes.
Welche Benchmarkwerte aussagekräftig sind – und welche nicht
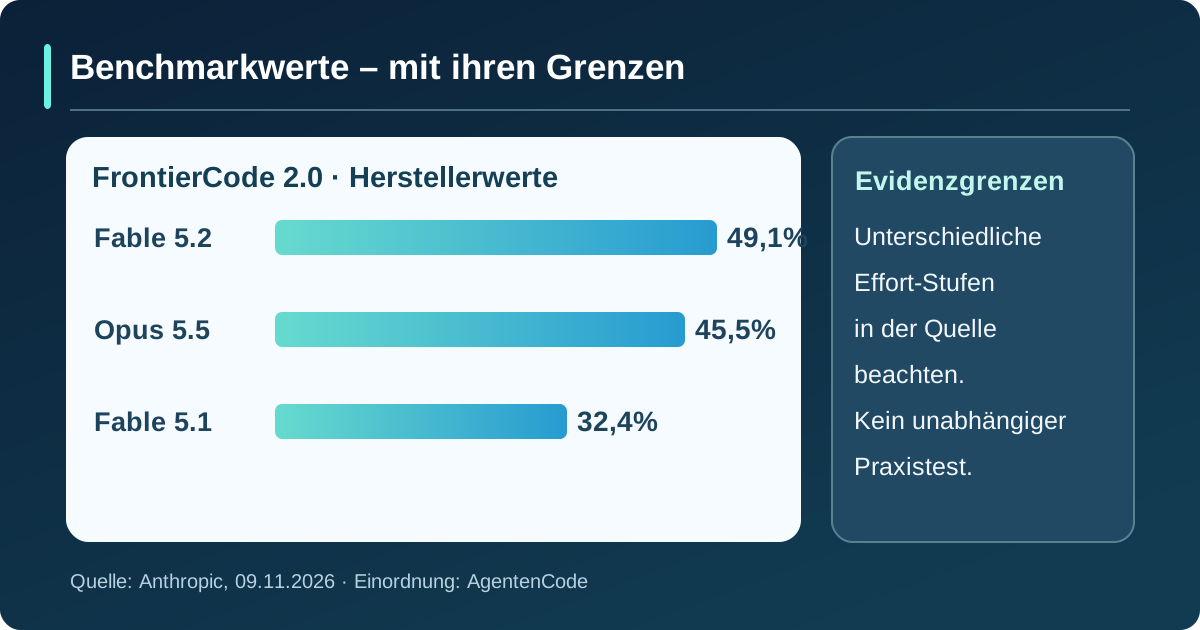
In der Anthropic-Tabelle erreicht Fable 5.2 auf FrontierCode 2.0 bei Xhigh-Effort 49,1 Prozent, Fable 5.1 32,4 Prozent und Opus 5.5 45,5 Prozent. Der Benchmark bewertet Codeänderungen im Kontext von Open-Source-Projekten. Auch FrontierSWE v2 und weitere Aufgaben weisen laut Anbieter Fortschritte auf. Scores aus verschiedenen Harnesses, Effort-Stufen oder nicht identischen Aufgaben dürfen aber nicht zu einer universellen Modellrangliste zusammengezogen werden.
Für Unternehmen ist die Vergleichbarkeit entscheidend: In einem eigenen Test müssten gleiche Repositories, festgelegte Aufgaben, Kostenlimits, Werkzeugrechte und Review-Regeln gelten. Eine 49,1-Prozent-Benchmarkzahl belegt nicht, dass 49,1 Prozent beliebiger Produktionsaufgaben autonom fehlerfrei abgeschlossen werden. Die folgende eigene Grafik macht die ausgewiesenen Vergleichswerte und ihre Grenzen sichtbar.
| Prüffeld | Angebot/Modell | Wert/Funktion | Grenze |
|---|---|---|---|
| FrontierCode 2.0 (Xhigh) | Fable 5.2 | 49,1 % | Herstellerbenchmark |
| FrontierCode 2.0 (Xhigh) | Fable 5.1 | 32,4 % | Herstellerbenchmark |
| FrontierCode 2.0 (best) | Opus 5.5 | 45,5 % | Abweichender Effort möglich |
Kosten, Geschwindigkeit und sinnvolle Aufgabenverteilung
Anthropic nennt regulär 8 US-Dollar je Million Eingabetokens und 40 US-Dollar je Million Ausgabetokens für Fable 5.2 und Mythos 5.2. Der optionale Fast Mode kostet laut Ankündigung 16 beziehungsweise 80 US-Dollar und soll die Token-Ausgabe um bis zum 2,5-Fachen beschleunigen. Diese Zahlen sind Listenpreise der Ankündigung; tatsächliche Projektkosten hängen von Kontext, Ausgabeumfang, Agentenschleifen und weiteren Diensten ab.
Anthropic beschreibt Fable nicht als günstigste Standardwahl für jede Aufgabe. Für gewöhnliche Programmier- und Wissensaufgaben empfiehlt der Hersteller zunächst Opus 5.5 und eine Eskalation nur für besonders schwere Fälle. Eine fachlich sinnvolle Agentenarchitektur setzt deshalb nicht alle Teilaufgaben auf das teuerste Modell, sondern trennt Orchestrierung, Routinetätigkeiten und kritische Prüfungen.
Fable oder Mythos: Schutzmechanismen sind keine Produkteigenschaft ohne Scope
Fable 5.2 enthält laut Anthropic Sicherheitsfilter, die bestimmte risikoreiche Cyber- und Biologieanfragen blockieren oder an ein anderes Modell weiterreichen. Mythos 5.2 wird unter anderen Zugangsbedingungen für verifizierte Organisationen angeboten. Daraus folgt weder, dass Fable jedes Sicherheitsrisiko ausschließt, noch dass Mythos allgemein ungeschützt zugänglich ist.
Anthropics veröffentlichte Audits, darunter Tests zu Sandbox-Ausbrüchen und irreführenden Antworten, sind wichtige Transparenzsignale. Ein Anbieter-Audit ersetzt jedoch keine unabhängige Bewertung der konkreten Integration mit Unternehmenskonten, Dateisystemrechten, Netzwerkzugriff und sensiblen Daten. Insbesondere für autonome Agenten bleibt die tatsächliche Berechtigungsgrenze zentral.
AgentenCode-Entscheidungsmatrix: Wann lohnt sich ein großes Agententeam?
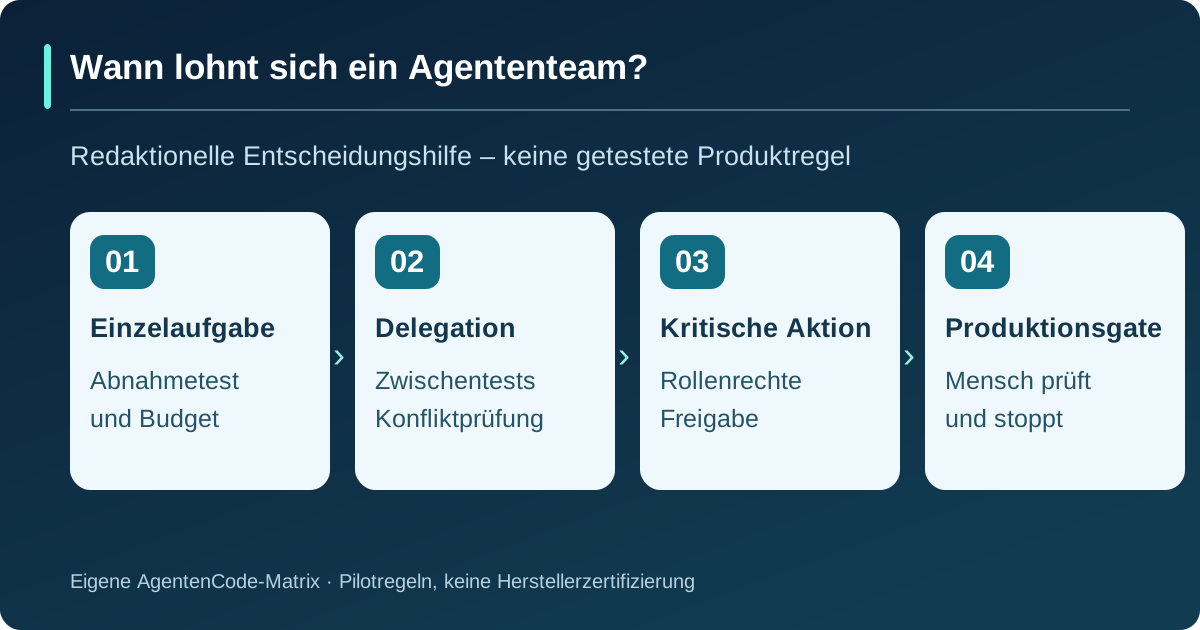
Unsere redaktionelle Matrix trennt drei Einsatzarten: eine klar begrenzte Einzelaufgabe, eine langlaufende delegierbare Engineering-Aufgabe und eine sicherheitskritische Automatisierung. Bei Routinearbeiten stehen Kostenlimit und reproduzierbares Ergebnis im Vordergrund; bei größeren Projekten sind Aufgabenzerlegung, unabhängige Tests und Konfliktbehandlung entscheidend; bei kritischen Aktionen müssen Genehmigungen und Abbruchmöglichkeiten von der Modellleistung getrennt sein.
Die Matrix ist eine AgentenCode-Ableitung aus der dokumentierten Architektur und Sicherheitslage, kein von uns gemessener Modellvergleich. Ein Betrieb sollte zuerst eine kleine wiederholbare Aufgabenstichprobe mit menschlicher Prüfung und festen Budgets evaluieren. Die Möglichkeit zur Delegation ist nur dann wertvoll, wenn der Abnahmepfad mindestens so gut skaliert wie die Arbeitsteilung.
Was jetzt für Unternehmen und Entwickler zu prüfen ist
Ein realistischer Pilot benötigt einen abgegrenzten Quellcodebereich, Testfälle mit erwartbaren Ergebnissen, ein Laufzeit- und Tokenbudget, klar definierte Tool-Rechte sowie eine menschliche Freigabe vor Änderungen an produktiven Systemen. Besonders aufschlussreich sind Aufgaben mit konkurrierenden Änderungsvorschlägen, widersprüchlichen Dokumenten und bewusst eingebauten Fehlern.
Die dokumentierten Ergebnisse rechtfertigen es, Multi-Agenten-Orchestrierung für schwere, prüfbare Aufgaben gezielt zu untersuchen. Sie rechtfertigen keine pauschale Aussage, Tausende Agenten seien in jeder Organisation wirtschaftlich oder sicher. Weiterführend helfen unsere Leitfäden KI-Agenten erstellen und Sicherheitsgrenzen für KI-Agenten.
Passende Agentenprofile: Claude Code und Claude Cowork sind eigene Agentenprodukte und nicht mit dem Modell Fable 5.2 gleichzusetzen.
Häufige Fragen
Sind Fable 5.2 und Mythos 5.2 zwei verschiedene Modelle?
Laut Anthropic verwenden sie denselben zugrunde liegenden Modellkern, unterscheiden sich aber durch Schutzmechanismen und Zugangsregeln.
Haben KI-Agenten Fermats letzten Satz neu bewiesen?
Nein. Der bekannte Beweis wurde in Lean formalisiert, also in eine maschinenprüfbare Darstellung übertragen.
Kann jeder Mythos 5.2 nutzen?
Nicht allgemein. Mythos-Zugang ist laut Anthropic an Verifizierungsprogramme gebunden.
Ist das Experiment ein unabhängiger Unternehmenstest?
Nein. Die hier genannten Versuche und Benchmarks stammen aus der Herstellerveröffentlichung; AgentenCode hat sie quellenkritisch eingeordnet, aber nicht selbst reproduziert.
Originalquellen und Methodik
Primärquellen geprüft am 11. November 2026. Anbieterangaben, redaktionelle Schlüsse und ungeprüfte Wirkungen sind getrennt. Benchmarks wurden nicht von uns ausgeführt.