
AWS macht KI-Agenten vergleichbar: Open-Source-Framework prüft 36 Qualitätsmerkmale
AWS veröffentlicht UAEF: ein offenes Evaluierungssystem mit 36 Messgrößen, 7 Dimensionen und Vergleichen zwischen Agent-Versionen und Frameworks. Chancen und Grenzen.
Wie gut ist der Agent nach dem letzten Update wirklich?
AWS hat am 11. November 2026 das Universal Agent Evaluation Framework (UAEF) vorgestellt. Die Open-Source-Software soll ein Problem beheben, das mit jeder neuen Agentenarchitektur wächst: Der Erfolg einer Aufgabe lässt sich nicht allein an einer überzeugend formulierten Antwort ablesen. Ein Agent könnte korrekten Text ausgeben und unterwegs dennoch falsche Tools verwenden oder unnötige Kosten verursachen.
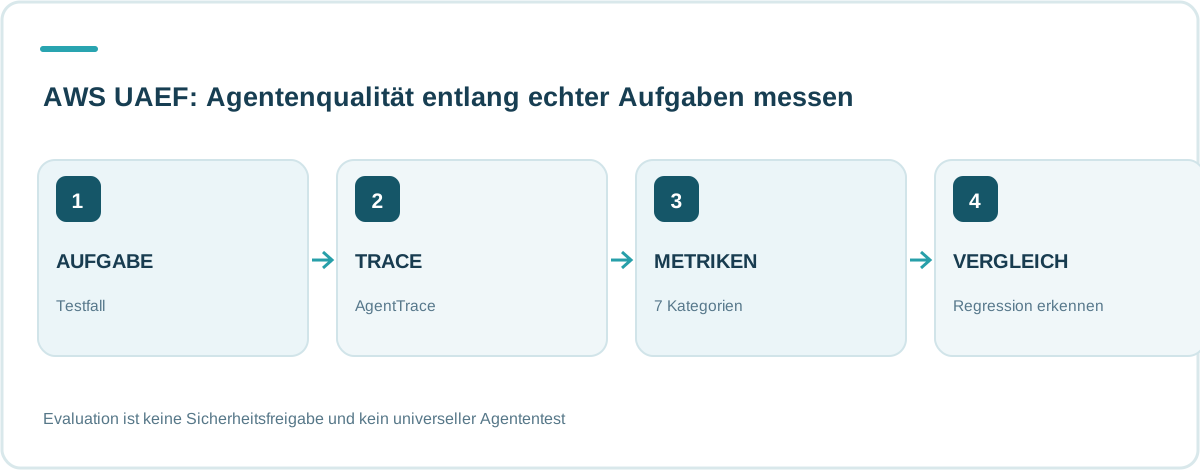
Deshalb bewertet UAEF nicht nur den abschließenden Text, sondern die Ausführung als Ganzes. Teams können dieselben Testfälle wiederholen, die Ergebnisse speichern und Agentenversionen miteinander vergleichen. Das ist besonders relevant, wenn ein Prompt, ein Modell oder eine Tool-Anbindung verändert wird und anschließend unerwartet andere Fehler auftreten.
Eine gemeinsame Spur für verschiedene Frameworks
LangGraph, LangChain, Strands Agents und Amazon Bedrock AgentCore zeichnen Agentenverläufe unterschiedlich auf. UAEF verwendet dafür Adapter, die Nachrichten, Tool-Aufrufe und Übergaben in das gemeinsame Format AgentTrace umwandeln. AWS nennt außerdem Langfuse und generische JSON-Traces als unterstützte Eingänge. Der Bewertungsprozess arbeitet anschließend unabhängig vom ursprünglichen Framework auf dem normalisierten Datensatz.
Die Standardisierung reduziert die Abhängigkeit von einem einzelnen SDK. Ein Team kann beispielsweise die Werkzeugnutzung eines bestehenden LangGraph-Agenten mit einer überarbeiteten Variante vergleichen, ohne die gesamten Bewertungsregeln neu zu schreiben. Die tatsächliche Aussagekraft hängt dabei von vollständigen Traces und einer passenden Referenzaufgabe ab.
36 Messgrößen in sieben Dimensionen
AWS beschreibt 36 integrierte Metriken, verteilt auf sieben Qualitätsbereiche: Tool Calling, Response Quality, Responsible AI, Performance, Multi-Turn, Multi-Agent und Reasoning. Die Messwerte liegen auf einer normierten Skala von 0 bis 1. So kann ein Bericht zeigen, ob ein Agent zwar schneller geworden ist, aber gleichzeitig häufiger das falsche Werkzeug auswählt.
Einige Metriken benötigen erwartete Antworten oder die erwartete Reihenfolge von Tool-Aufrufen als Ground Truth. Andere können aus vorhandenen Traces berechnet werden. Wer alle Werte auf einen einzigen Gesamtwert reduziert, riskiert jedoch, schwerwiegende Fehler bei einem sicherheitskritischen Teilschritt zu übersehen. Eine hohe Zahl ist kein allgemeiner Intelligenz- oder Sicherheitstest.
Der eigentliche Wert liegt im Vergleich über die Zeit
Das Framework kann Einzelversuche und ganze Datensätze evaluieren, im passiven Modus vorhandene Protokolle auswerten oder einen Agenten aktiv aufrufen. Gespeicherte Experimente verwenden laut AWS Amazon DynamoDB für Metadaten und Amazon S3 für ausführlichere Ergebnisse. Daraus lassen sich Baselines und Berichte ableiten, um Verschlechterungen nach einer Änderung sichtbar zu machen.
Ein praktisches Beispiel: Ein Kundenservice-Agent wechselt auf ein neues Modell. Die Antwortqualität bleibt gut, doch plötzlich werden mehr falsche CRM-Aktionen vorgeschlagen. Ein gezielter Regressionstest mit bekannten Aufgaben kann diesen Unterschied offenlegen. Der Wert des Systems entsteht dadurch, dass die Testfälle realistische Risiken abdecken und nicht nur einfache Erfolgsbeispiele.
Deterministische Tests und KI als Bewerter
Nicht jede Frage lässt sich mit derselben Methode bewerten. Ob ein Tool mit den erwarteten Parametern aufgerufen wurde, lässt sich bei geeigneter Referenz deterministisch prüfen. Dagegen erfordern Aspekte wie Relevanz oder Kontexttreue teilweise ein Bewertungsmodell, einen sogenannten LLM-as-a-Judge. AWS trennt diese beiden Familien ausdrücklich.
Weil Agentenausgaben selbst bösartige Anweisungen enthalten können, beschreibt AWS Schutzmaßnahmen gegen Manipulation des Bewerters: getrennte Bewertungsrubriken, abgegrenzte Eingaben und überprüfbare Textbelege. Trotzdem bleibt ein LLM-Urteil ein Schätzsignal. Ein Evaluierungswert darf keine technische Zugangssperre oder Runtime-Sicherheitsregel ersetzen.
Datenschutz und Infrastruktur sind Teil der Bewertung
Agenten-Traces können E-Mail-Adressen, Telefonnummern, Kundentexte und andere vertrauliche Informationen enthalten. UAEF enthält deshalb Funktionen zur Erkennung und Bearbeitung personenbezogener Angaben vor der Speicherung. Das ist ein wichtiger Baustein, aber keine Garantie dafür, dass jede sensible Information zuverlässig anonymisiert wird.
Auch der Infrastrukturaufwand muss berücksichtigt werden. Die Python-Bibliothek allein muss keine AWS-Ressourcen anlegen. Persistierte Ergebnisse benötigen jedoch S3 und DynamoDB; LLM-Bewertungen können Modellkosten auslösen. AWS weist darauf hin, dass bestimmte Ressourcen nach dem Löschen einer Deployment-Umgebung ausdrücklich bestehen bleiben können und deshalb separat entfernt werden müssen.
Open Source heißt überprüfbarer Code – nicht überprüfte Ergebnisse
Der Quellcode von UAEF steht unter Apache 2.0 zur Verfügung. Das Repository bietet eine Python-Bibliothek, Adapter, Beispiele und Infrastruktur für eine Weboberfläche. AWS berichtet von der Nutzung durch zwölf Organisationen in Telekommunikation, Gesundheit und Finanzen. Diese Zahl stammt aus der Anbieterkommunikation; sie belegt keine unabhängig geprüfte Kosteneinsparung oder Erhöhung der Erfolgsquote.
Auch die 36 UAEF-Messgrößen sollten nicht mit den 36 Kontrollfeldern von AgentenTrust verwechselt werden. UAEF untersucht das Verhalten von Agenten in Tests. AgentenTrust dokumentiert, welche Kontroll- und Sicherheitsmerkmale eines Produkts anhand von Quellen belegt sind. Beide Perspektiven können sich ergänzen, erfüllen aber unterschiedliche Aufgaben.
AgentenCode-Einordnung: Zuverlässigkeit wird wichtiger als Demo-Eindruck
UAEF setzt an einem Kernproblem produktiver KI-Agenten an: Ein gutes Modell macht noch keinen zuverlässigen Geschäftsprozess. Qualität hängt auch von Werkzeugwahl, erwartbaren Seiteneffekten, Wiederholbarkeit und Kosten ab. Die Möglichkeit, Modell- und Promptwechsel gegen eine feste Testbasis zu messen, ist deshalb ein wertvoller Ansatz.
Wir halten ein aufgabenspezifisches Evaluierungsset für wichtiger als eine allgemeine Zahl. Wer einen Agenten produktiv einsetzen möchte, sollte Fehlschläge, unzulässige Tool-Aufrufe und manuelle Eingriffe ausdrücklich mitzählen. Mit dem AgentenArchitekt lässt sich die Testarchitektur planen; unsere AgentenTrust-Methodik betrifft die ergänzende Quellen- und Kontrollprüfung. UAEF wurde von AgentenCode nicht selbst benchmarked oder sicherheitstechnisch auditiert.
Häufige Fragen
Was ist das Universal Agent Evaluation Framework?
UAEF ist ein quelloffenes AWS-System zur frameworkübergreifenden Evaluierung von Agentenaufgaben anhand normalisierter Ausführungstraces.
Welche Agentenframeworks unterstützt UAEF?
AWS nennt unter anderem LangGraph, LangChain, Strands Agents, Bedrock AgentCore, Langfuse und einen generischen JSON-Adapter.
Sind 36 Metriken gleichbedeutend mit einer Sicherheitszertifizierung?
Nein. Die Zahlen bewerten definierte Testaufgaben; technische Sicherheitskontrollen müssen unabhängig durchgesetzt werden.
Ist UAEF kostenlos nutzbar?
Der Code ist unter Apache 2.0 offen. Modellaufrufe sowie Speicher- und Infrastrukturressourcen können Kosten verursachen.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- AWS Machine Learning Blog — UAEF: A framework-agnostic system for closed-loop evaluation of AI agents (11 November 2026)
- AWS Labs — Universal Agent Evaluation Framework, source and Apache 2.0 license
- AWS Labs — UAEF technical guide and built-in metric catalog
Stand: 16. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.