
Cisco testet KI-Agenten mit Claude Mythos – was ist wirklich verfügbar?
Cisco will KI-Agenten mit Claude Mythos in kontrollierten Szenarien angreifen lassen und ihre Qualität und Kosten mit Splunk überwachen. Was davon ist bereits verfügbar?
Cisco verbindet KI-Red-Teaming, Agentenbewertung und Kostenkontrolle. Mythos ist noch nicht allgemein verfügbar.
Kurzantwort
Cisco will das Sicherheitsprodukt AI Defense um einen kontrollierten Red-Teaming-Einsatz von Anthropic Claude Mythos ergänzen und mit neuen Funktionen für Splunk Agent Observability verknüpfen. Unternehmen sollen autonome Agenten dadurch gezielter auf mehrstufige Angriffswege testen und gleichzeitig Ergebnisse, Kosten und Qualität ihrer Agentenläufe überwachen können. Der entscheidende Vorbehalt: Die Funktionen werden nicht gemeinsam und nicht gleichzeitig allgemein verfügbar.
1 · Was Cisco tatsächlich ankündigt
Die am 9. November veröffentlichte Mitteilung beschreibt drei Stränge: AI Defense soll anspruchsvollere, kontextspezifische Angriffe auf KI-Anwendungen und Agenten durchplanen; Splunk Agent Observability verknüpft Traces, Modellbewertungen und Token-Kosten; Cisco IQ soll Infrastruktur- und Schwachstelleninformationen über Data Fabric, MCP- und ServiceNow-Anbindungen besser in operative Abläufe bringen. Das ist ein Vorschlag für einen zusammenhängenden Sicherheitsprozess, keine bereits nachgewiesene Ende-zu-Ende-Schutzgarantie. Gerade bei Agenten mit Browser-, Repository-, Ticket- oder Cloud-Rechten zählt weniger eine abstrakte Modellbewertung als die Frage, welche konkreten Aktionsketten trotz ihrer Grenzen möglich wären.
2 · Claude Mythos ist hier Testwerkzeug, kein unbeschränkter Hacker-Agent
Nach Cisco sollen Kunden Claude Mythos ausschließlich über die strukturierte AI-Defense-Schnittstelle nutzen können – nicht über freien Promptzugang. Red-Teaming-Ziele müssen registriert und zum Test autorisiert sein; Aktivitäten sind einem benannten Operator zugeordnet. Tests laufen mit festgelegten Zielen, zeitlichen Grenzen, Prüfprotokollen und Abbruchmöglichkeit. Diese Grenzen sind wesentlich: Red-Teaming ohne Eigentums- und Berechtigungsnachweis würde aus Sicherheitsprüfung schnell ein zusätzliches Risiko machen. Diese Kontrollmechanismen sind Cisco-Angaben, keine von AgentenCode eigenständig überprüfte Isolation.
3 · Agenten messen heißt mehr als Tokens zählen
Splunk Tokenomics soll Kosten einzelnen Agentenläufen und ihrer Arbeitsqualität zuordnen. Eval-G1 nutzt laut Cisco Traces und Expertenfeedback, um spezialisierte Evaluierungsmodelle aufzubauen; mit Evaluation Tuner sollen Teams Qualitätsregeln nachschärfen. Die von Cisco angeführten Werte zu bis zu 98 Prozent niedrigeren Evaluierungskosten und 2,5-facher Antwortgeschwindigkeit sind Herstellerangaben für den beschriebenen Vergleich, keine unabhängige AgentenCode-Messung und kein allgemeines Kostensparversprechen. Ein günstiger Agent ist nur dann wirtschaftlich, wenn das Ergebnis geprüft, der Handlungsspielraum passend und Fehlerkosten erfasst sind.
4 · Statusmatrix: Was ist wann verfügbar?
| Baustein | Cisco-Angabe | Praktische Schlussfolgerung |
|---|---|---|
| Mythos-gestütztes adaptives Red-Teaming | Kommt bald, zunächst ausgewählte Enterprise-Kunden | Nicht als heute allgemein buchbares GA-Produkt darstellen |
| Splunk Tokenomics | Private Preview im Dezember 2026, GA im AWS Marketplace Anfang 2027 geplant | ROI- und Kostenversprechen im Pilot evaluieren, nicht als allgemeine Verfügbarkeit behaupten |
| Eval-G1 und Evaluation Tuner | Laut Ankündigung GA ab November 2026 | Laufende Verfügbarkeit und Vertrags-/Regionseinschränkungen im eigenen Tenant bestätigen |
| Cisco IQ / MCP / ServiceNow | Integrations- und Workflow-Erweiterungen angekündigt | Autorisierungs- und Schreibrechte getrennt von reinem Lagebild überprüfen |
5 · AgentenCode-Entscheidungsrahmen
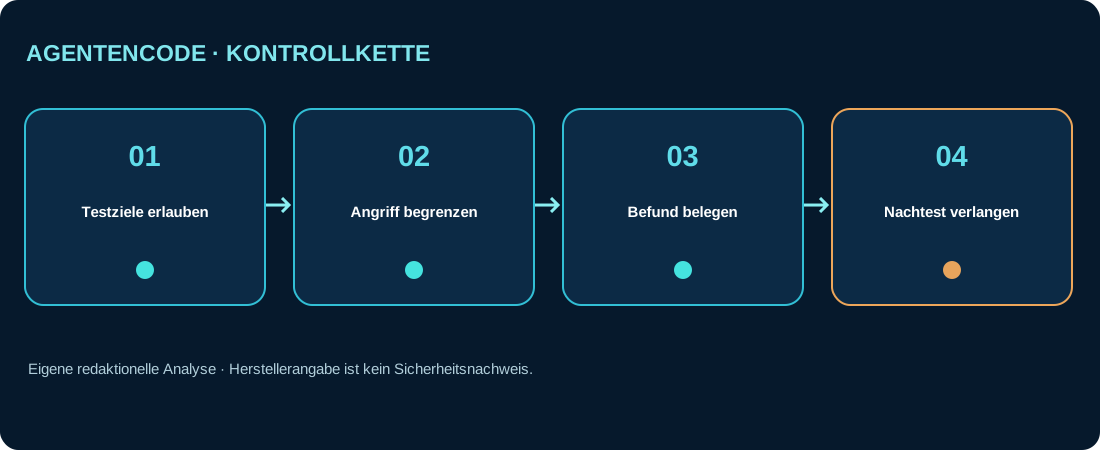
Vor einem Pilot sollten drei Grenzen getrennt geprüft werden. Testgrenze: Welche Systeme dürfen angegriffen werden, wie wird Zustimmung belegt, wer kann einen Lauf stoppen? Daten- und Aktionsgrenze: Welche produktiven Secrets, Kundeninhalte und Tool-Ausführungen sind aus einer Testumgebung erreichbar? Qualitätsgrenze: Werden gefundene Schwachstellen tatsächlich reproduziert, behoben und erneut getestet oder nur mit einem Score versehen? Erst wenn diese Fragen nachvollziehbar beantwortet sind, wird ein kontinuierlicher Prüfprozess zu mehr als einer attraktiven Dashboard-Idee.
6 · Was offenbleibt
Cisco liefert keine unabhängig verifizierten Zahlen zur Fehlerfindung in konkreten Kunden-Agenten, zur Rate falscher positiver Befunde oder zu vollständigen ROI-Effekten des neuen Pakets. Auch Datenschutz, Modellrouting, Speicherdauer der Angriffsprotokolle und Regionsgrenzen können je Produkt und Vertrag abweichen. Die Anwendung von Mythos in AI Defense sagt zudem nichts darüber aus, ob Mythos für andere Nutzungen allgemein verfügbar ist.
7 · Einordnung und FAQ
Unsere Einordnung: Mit wachsender Autonomie rückt der Sicherheitsmaßstab von „Ist das Modell gut?“ zu „Welche Aktionen kann dieser Agent ausführen, was lässt sich beweisen, und wer stoppt ihn?“ Cisco verbindet diese drei Prüfweisen erstmals in einer konkreten neuen Ankündigung, aber der Rollout ist gestaffelt.
Ist Claude Mythos in Cisco AI Defense schon allgemein verfügbar? Nein. Laut Cisco folgt der Zugang demnächst für ausgewählte Unternehmen.
Sind die bis zu 98 Prozent niedrigeren Evaluierungskosten unabhängig geprüft? Nicht durch AgentenCode. Es handelt sich um einen von Cisco dargestellten Vergleich, dessen Basis ein Unternehmen vor einer Entscheidung nachvollziehen sollte.
Kann das Produkt alle gefährlichen Agentenaktionen verhindern? Eine solche Garantie enthält die Quelle nicht. Kontrollen, Autorisierungen, Audit-Trails und erneute Tests sind weiterhin notwendig.
---