
Google MKA-Benchmark: Können KI-Agenten echte Dokumentenarbeit erledigen?
Eine KI kann Textfragen perfekt beantworten und trotzdem eine falsche Excel-Formel abgeben oder einen wichtigen Hinweis auf einer technischen Zeichnung übersehen. Genau solche Fehler soll der neue MKA-Benchmark sichtbar machen.
MKA vergleicht Agenten anhand von 200 privaten, fachlich entworfenen Aufgaben in einem gemeinsamen Test-Harness. Eine gute Platzierung misst Dateiarbeit unter Testbedingungen – nicht die Sicherheit eines konkreten Unternehmensprozesses.
Was macht MKA neu?
Google DeepMind und Artificial Analysis haben am 10. November 2026 den Multimodal Knowledge Agent (MKA) Benchmark vorgestellt. Er testet nicht nur kurze Textantworten, sondern vollständige Projekte mit visuellen Eingaben wie Bauzeichnungen, Diagrammen, PDF-Dokumenten und Tabellen.
Agenten sollen daraus verwendbare Arbeitsergebnisse erzeugen: Berichte, Tabellen, Präsentationen oder markierte Zeichnungen. Die zentrale Frage lautet deshalb: Stimmt das finale Dokument – nicht nur die Zusammenfassung am Ende des Chats?
200 Aufgaben aus zehn Branchen
Der private Test umfasst 200 Aufgaben aus zehn Branchen und 83 Berufsbildern. Fachleute erstellten realistische Arbeitsaufträge, die laut Google für erfahrene Menschen oft drei bis acht Stunden benötigen. Die Eingaben bestehen aus mehreren Dateien mit unterschiedlichen Formaten.
Die Experten-Rubriken enthalten laut Google typischerweise etwa 70 Ja/Nein-Kriterien, die zu 75 Prozent die sachliche Richtigkeit und zu 25 Prozent die visuelle Gestaltung gewichten. Das testet auch die praktische Brauchbarkeit eines Ergebnisses.
Gleiche Werkzeuge im offenen Stirrup-Harness
Artificial Analysis führt die Agenten in einem gemeinsamen Open-Source-Harness namens Stirrup aus. Laut Methodik erhalten Modelle eine Linux-Sandbox mit kontrollierten Werkzeugen, bis zu 250 Turns und bis zu acht Stunden pro Aufgabe.
Der Vergleich wird dadurch aussagekräftiger, weil unterschiedliche Chat-Oberflächen und proprietäre Agentensysteme nicht im selben Maß den Score bestimmen. Ganz neutral ist der Rahmen dennoch nicht: Modelle unterscheiden sich in Tool-Strategien, Dateiverständnis und Kosten.
Was bedeutet 96 Prozent Prüferübereinstimmung?
Der automatische Bewerter öffnet fertige Dateien, rendert Seiten, kontrolliert Formeln und prüft Rubrikkriterien. Google berichtet eine 96-prozentige Übereinstimmung mit menschlichen Gutachten in der untersuchten Bewertungsstichprobe.
Das ist ausdrücklich keine Erfolgsquote der Agenten. Die Kennzahl beschreibt die Übereinstimmung zwischen Bewertungen. Artificial Analysis veröffentlicht als zentrale Metrik Climb WSR – den gewichteten Anteil erfüllter anspruchsvoller Kriterien – und trennt davon Basiskriterien.
Modelle, Kosten und Agentenschritte
Google meldet für Gemini 4 Carbon den zweiten Qualitätsrang unter den getesteten Modellen bei durchschnittlich deutlich niedrigeren Kosten pro Aufgabe als dem Spitzenmodell. Diese Einordnung gehört exakt zu diesem Benchmark und ist keine pauschale Aussage über alle Agentenprodukte.
Die Entwickler berichten außerdem von sehr unterschiedlichen Laufstrategien: Im Mittel nutzten die verglichenen Modelle ungefähr 30 bis 130 Turns. Für die eigene Auswahl sollte man deshalb Qualität, Fehlerrate, Laufzeit und Kosten nicht in einer einzigen Rangliste vermischen.
Private Tests gegen Datenleckage
Die 200 Wertungsaufgaben bleiben privat, um die Aufnahme von Aufgaben in Trainingsdaten und direktes Benchmark-Gaming zu erschweren. Gleichzeitig sind zehn öffentliche Beispielaufgaben verfügbar, damit Dritte den Aufbau und die Eingabeformate untersuchen können.
Der Vorteil ist ein robusteres Testszenario; der Nachteil ist die begrenzte vollständige Reproduzierbarkeit durch unabhängige Teams. Unternehmen brauchen zusätzlich eigene, dokumentierte Testfälle, die Datenrechte, Fehlerkorrektur und reale Dateiformate berücksichtigen.
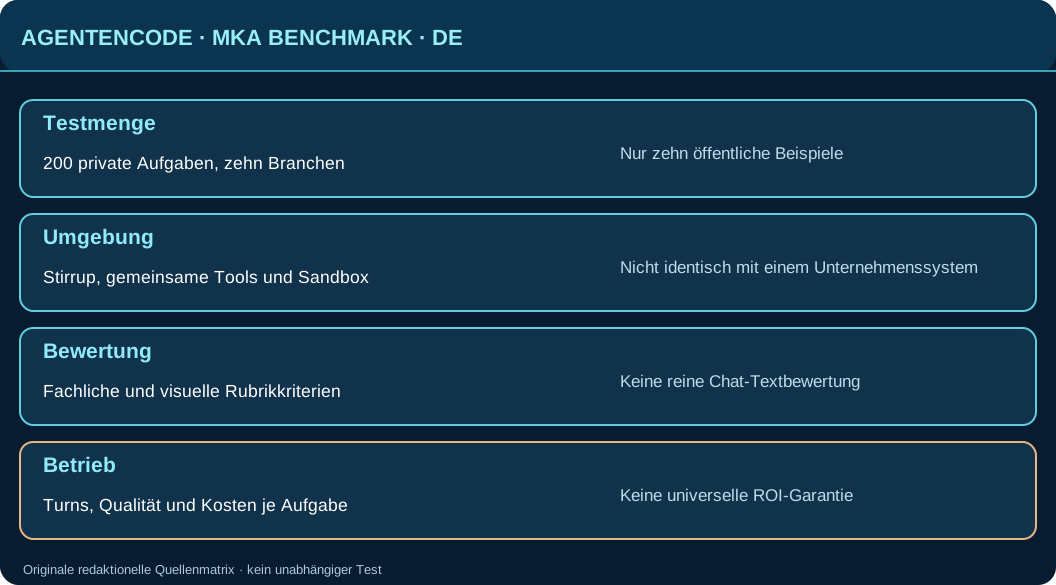
| Prüffeld | Belegter Stand | Kontrollfrage |
|---|---|---|
| Testmenge | 200 private Aufgaben, zehn Branchen | Nur zehn öffentliche Beispiele |
| Umgebung | Stirrup, gemeinsame Tools und Sandbox | Nicht identisch mit einem Unternehmenssystem |
| Bewertung | Fachliche und visuelle Rubrikkriterien | Keine reine Chat-Textbewertung |
| Betrieb | Turns, Qualität und Kosten je Aufgabe | Keine universelle ROI-Garantie |
AgentenCode-Analyse: Das Artefakt zählt
Die eigentliche Verbesserung liegt im Bewertungsgegenstand: Ein gut klingender Abschlussbericht kann eine kaputte Tabellenformel, ein ausgelassenes Maß oder eine unlesbare Folie verdecken. MKA prüft deshalb das gelieferte Arbeitsprodukt – ein für agentische Automatisierung sinnvoller Maßstab.
Wir empfehlen drei getrennte Prüfkategorien: fachliche Korrektheit, tatsächliche Verwendbarkeit des Artefakts und benötigte Ressourcen. Dazu kommen Quellenherkunft und Berechtigungen. Das ist unsere redaktionelle Prüflogik, kein von uns ausgeführter Benchmark.
Agentenprofile, FAQ und weitere Quellen
Gemini Deep Research und ChatGPT Deep Research sind passende Produktkontexte, jedoch nicht mit dem MKA-Test-Harness identisch. Mehr dazu in Agenten-Evals und Agenten-Monitoring.
Ist MKA selbst ein KI-Agent? Nein, ein Evaluationsrahmen. Sind alle Aufgaben öffentlich? Zehn Beispiele sind öffentlich, das Wertungsset bleibt privat. Ist die 96-Prozent-Angabe Modellgenauigkeit? Nein, sie beschreibt die Übereinstimmung von Bewertungen.
Originalquellen und Methodik
- Google DeepMind – Introducing the MKA benchmark (10 Nov 2026)
- Artificial Analysis – Multimodal Knowledge Agent evaluation
- Artificial Analysis – Intelligence benchmarking methodology
- Google DeepMind – Gemini 4 Carbon (technical context)
Primärquellen geprüft am 10. November 2026. Anbieter- und Benchmarkwerte werden nicht als eigene Tests oder Zertifizierungen ausgegeben.