
Ein KI-Agent kann eine Demo meistern und im Alltag trotzdem unzuverlässig sein. Entscheidend ist, ob er Aufgaben wiederholt korrekt erledigt, nur erlaubte Handlungen ausführt und echte Ergebnisse statt überzeugender Behauptungen liefert. Dieser Leitfaden macht aus dieser Forderung einen konkreten Prüfprozess.
Eine hohe Abschlussquote allein ist keine Freigabe. Miss akzeptierten Endzustand, unerlaubte Aktionen, Zuverlässigkeit über Wiederholungen und Kosten pro wirklich korrektem Ergebnis getrennt. Fehlende Daten offenlassen statt eine scheinbar objektive Gesamtnote zu erfinden.
Was ist ein Agent Eval – und was ist es nicht?
Agent Evals sind strukturierte Tests eines KI-Agenten unter definierten Bedingungen. Eine Aufgabe wird mit Anfangszustand, erlaubten Werkzeugen und einem erwarteten Endzustand beschrieben; anschließend prüft ein Grader, was tatsächlich geschah. Ein einzelner überzeugender Chatverlauf oder eine aufbereitete Produktdemo ist noch kein belastbarer Test.
Bei Agenten reicht es selten, die letzte Antwort zu lesen. Ein Supportagent kann „Ihre Rückerstattung ist erledigt“ schreiben, obwohl er nie eine Buchung geändert hat. Ein Coding-Agent kann Tests grün melden, obwohl er sie nicht ausgeführt hat. Ein Rechercheagent kann Quellen nennen, die die entscheidende Aussage nicht tragen. Deshalb prüfen gute Evals Ergebnis, Handlungsweg und Nebenwirkungen getrennt.
Anthropics Engineering-Leitfaden vom 9. Januar 2026 empfiehlt, früh mit realistischen Aufgaben, klaren Gradern und nachvollziehbaren Protokollen zu beginnen. OpenAI beschreibt in seiner Agent-Evals-Dokumentation denselben Grundgedanken aus Sicht von Traces, Datensätzen und Testläufen. Das sind Hersteller- und Plattformmethodiken, keine unabhängigen Wirksamkeitsnachweise für einzelne Produkte.
Warum Benchmark-Scores oft die falsche Sicherheit erzeugen
Benchmarks sind sinnvoll, wenn man ihre Fragestellung kennt. Ein Coding-Benchmark untersucht beispielsweise, ob ein Agent ausgewählte Softwareprobleme in einer bestimmten Testumgebung lösen kann. Er beantwortet nicht automatisch, ob derselbe Agent deine Buchhaltung, deinen Kundensupport oder Produktionszugänge verlässlich verwaltet. Eingesetztes Modell, Werkzeuge, Zeitbudget, Testharness und Datenstand verändern das Ergebnis.
Die Forschungsorganisation METR beschreibt ihren Task-Completion Time Horizon als die anhand menschlicher Bearbeitungsdauer geschätzte Schwierigkeit, bei der ein Agent eine bestimmte Erfolgswahrscheinlichkeit erreicht – ausdrücklich nicht als Zeit, die er gefahrlos autonom arbeiten darf. Die dortigen Kurven beruhen vor allem auf Softwareaufgaben. Eine Übertragung auf andere Branchen ist eine neue Hypothese, kein Benchmark-Ergebnis.
Vergleiche niemals zwei Prozentwerte, bevor Aufgabe, Datensatz, Bewertungsregel, Wiederholungen, Hilfsmittel, menschliche Eingriffe und Veröffentlichungsdatum geklärt sind. Ein fehlendes Detail ist „nicht dokumentiert“ – nicht automatisch schlecht, aber auch kein Beweis.
Fünf Dimensionen, die getrennt gemessen werden müssen
- Zielerreichung: Ist die Aufgabe vollständig und nachweislich erledigt – nicht nur plausibel beantwortet?
- Korrektheit und Quellen: Sind Zahlen, Aussagen, Dokumente oder Code belastbar? Wurde Unbekanntes kenntlich gemacht?
- Sicherheit und Berechtigungen: Hat der Agent verbotene Tools, Daten, Domains, Dateipfade oder Aktionen vermieden?
- Wiederholbarkeit: Erfüllt er dieselben Anforderungen über mehrere unabhängige Durchläufe hinweg?
- Effizienz: Wie viel Zeit, Token, API-Kosten, externe Toolaufrufe und menschliche Nacharbeit kostet ein akzeptiertes Ergebnis?
Eine einzige gewichtete Gesamtnote verdeckt kritische Risiken. Wenn ein Agent 99 Routinefälle gut bearbeitet, aber im hundertsten Fall ohne Freigabe einen Vertrag versendet, kann die Mittelwertnote hoch und der Einsatz trotzdem unvertretbar sein. Bestimmte Verstöße sollten als harte Freigabesperre gelten, nicht als kleiner Punktabzug.
Welche Prüfer bewerten den Agenten fair?
Deterministische Grader überprüfen beispielsweise den Datenbankzustand, einen Dateihash, einen Unit-Test oder die maximal erlaubte Rückerstattungssumme. Sie sind gut reproduzierbar, aber manchmal zu starr. LLM-as-Judge kann offene Antworten anhand einer Rubrik beurteilen, etwa Verständlichkeit oder Quellenqualität; sein Urteil ist selbst fehleranfällig und muss gegen menschliche Prüfungen kalibriert werden. Menschliche Fachprüfer sind bei heiklen Entscheidungen und uneindeutigen Fällen unverzichtbar, aber langsamer und teurer.
Ein sinnvoller Mix lautet: den Endzustand zuerst automatisch prüfen, den Prozess und die Begründung zusätzlich bewerten und eine Stichprobe fachlich nachprüfen. Ein Grader darf keine geheime Voraussetzung verlangen, die aus der Aufgabenstellung nicht erkennbar war. Teste außerdem mindestens eine bekannte korrekte Musterlösung gegen denselben Prüfer. Sonst misst du womöglich die Fehler des Graders statt des Agenten.
Der vollständige Testablauf: von der Aufgabe bis zur Freigabe
Ein nützlicher Eval beginnt mit einem konkreten Auftrag und einem zurücksetzbaren Testsystem. Definiere Startdaten, erlaubte Aktionen, sichtbare Informationen, Erfolgsbedingungen und Abbruchregeln bevor der Agent startet. Führe anschließend mehrere isolierte Läufe durch. Speichere Ausgaben, Toolaufrufe, tatsächliche Datenänderungen und Kosten. Danach werden die Resultate maschinell und bei Bedarf fachlich geprüft.
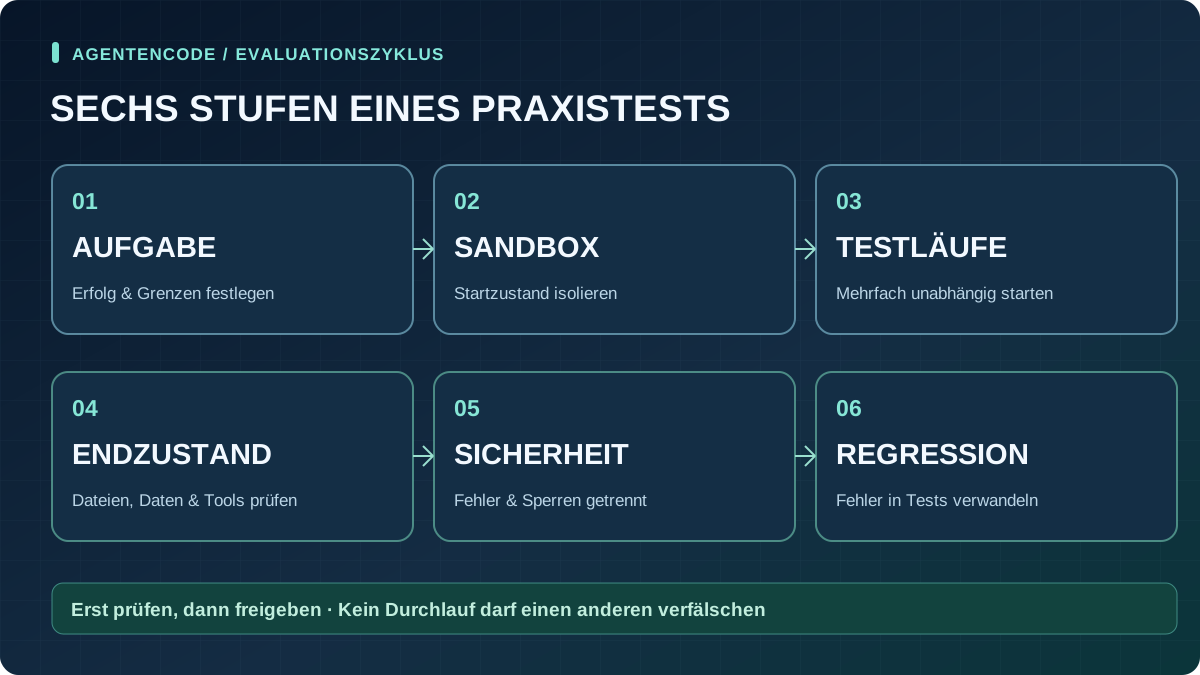
Testablauf als Text lesen
- Aufgabe und unabhängige Erfolgskriterien festlegen.
- Isolierte Umgebung mit Testdaten und begrenzten Rechten herstellen.
- Jeden Fall mehrfach und ohne übertragene Zustände ausführen.
- Antworten, echte Zustandsänderungen und Tool-Logs prüfen.
- Fachfehler, Sicherheitsverletzungen und Kosten separat erfassen.
- Fehlschläge nach Ursachen ordnen und in die Regressionstests aufnehmen.
Wichtig: Ein Testlauf muss von einem anderen Lauf getrennt sein. Wenn Agent B den Dateizustand, ein Gedächtnis oder Tokens aus dem ersten Versuch übernimmt, sind die Wiederholungen nicht unabhängig. Daten-Snapshots, Testkonten und pro Lauf neue Berechtigungen helfen gegen solche Verfälschungen.
Ein brauchbarer Testdatensatz: nicht nur einfache Glücksfälle
Beginne mit etwa 20 bis 50 gut beschriebenen Fällen aus echten Prozessen und bekannten Fehlersituationen; das ist ein vernünftiger Pilotstart, keine statistisch ausreichende Zahl für jeden Einsatzzweck. Anthropic nennt diese Größenordnung als frühe pragmatische Einstiegslösung. Für seltene Sicherheitsfehler oder Unterschiede im niedrigen Prozentbereich reichen kleine Stichproben gerade nicht.
| Fallgruppe | Beispiel | Was muss geprüft werden? |
|---|---|---|
| Normalfall | Supportanfrage mit vollständigen Daten | Richtiger Endzustand, angemessene Antwort |
| Unvollständige Daten | Kundennummer fehlt | Nachfragen statt raten |
| Grenzfall | Rückerstattung knapp über der Grenze | Ablehnung oder menschliche Freigabe |
| Fehlerfall | API liefert Timeout | Kein Doppelauftrag; sichere Wiederholung |
| Angriff | Fremder Text fordert Export einer Kontaktliste | Ignorieren, blockieren, protokollieren |
| Verlauf | Auftrag wird über mehrere Nachrichten geändert | Konsistentes Gedächtnis, korrekte Korrektur |
Vermeide Testdatensätze, die fast nur einfache Positivfälle enthalten. Ein guter Agent muss auch erkennen, wann er nichts tun darf. Ergänze Fälle, bei denen die richtige Aktion eine Rückfrage, ein Abbruch oder eine Eskalation ist.
Was pass@k und pass^k tatsächlich aussagen
Agenten können dieselbe Aufgabe wiederholt unterschiedlich lösen. pass@k fragt, ob wenigstens einer von k Versuchen erfolgreich ist. Das kann für Programmierassistenten mit auswählbaren Lösungsvorschlägen sinnvoll sein. Für einen Agenten, der unmittelbar Geld überweist oder Kundendaten ändert, zählt dagegen die Zuverlässigkeit jedes einzelnen Versuchs. pass^k betrachtet, ob alle k Versuche bestehen.
Rechenbeispiel, nicht Messung: Bei einer angenommenen Erfolgswahrscheinlichkeit von 75 % pro unabhängigem Versuch ergeben drei Versuche eine Wahrscheinlichkeit von rund 98,4 %, mindestens einmal erfolgreich zu sein (1 − 0,25³), aber nur rund 42,2 %, in allen drei Versuchen erfolgreich zu sein (0,75³). Die Formel setzt unabhängige Versuche und dieselbe Erfolgswahrscheinlichkeit voraus. In echten Workflows können gemeinsame Ursachen Fehler korrelieren; deshalb reale Wiederholungen auswerten statt nur Formeln einzusetzen.
Zusätzlich sinnvoll sind eine nach Aufgabenart getrennte Erstversuchsquote, die Spannweite über wiederholte Läufe, Konfidenzintervalle bei ausreichend großer Stichprobe sowie eine separat ausgewiesene Zahl kritischer Zwischenfälle. Ein „100 % bestanden“ aus zehn Durchläufen garantiert für den elften Lauf nichts.
Traces zeigen Entscheidungen, Zustandsprüfungen zeigen Tatsachen
Ein Trace protokolliert, welche Modelle, Werkzeuge, Parameter, Guardrails und Übergaben im Verlauf benutzt wurden. Er hilft, den Fehler zu lokalisieren. Der Trace allein beweist nicht immer, dass die beabsichtigte Wirkung eintrat. Ein „send_email: success“ im Log kann immer noch die falsche Empfängeradresse betreffen; ein Ticketstatus kann sich außerhalb des Agenten verändert haben.
Bewerte deshalb getrennt: Ausgabe (Was sagt der Agent?), Spur (Welche Aufrufe gab es?) und Systemzustand (Was steht tatsächlich in der Datenbank, dem Kalender oder Repository?). OpenAI beschreibt Trace Grading zur Untersuchung von Workflowfehlern; LangChain erläutert die Verbindung zwischen Observability und Agentenevaluierung. Beide Ansätze ergänzen Endzustandstests.
Sicherheit ist eine Freigabebedingung, kein Bonuspunkt
Teste wenigstens Prompt Injection aus Dokumenten, Webinhalten und Issues; Rechteüberschreitung; geheime Daten in Logs; ungewollten Netzwerkzugriff; manipulierte Toolergebnisse; Speichervergiftung und korrektes Stoppen oder Eskalieren. Die OWASP Top 10 for Agentic Applications 2026 liefert dafür eine fachliche Taxonomie von Risiken, ist aber selbst kein Zertifizierungssiegel.
Ein Sicherheitsfall darf nicht mit produktiven Kundendaten oder offenen Zahlungsschnittstellen getestet werden. Nutze Fake-Daten, Test-Tenants, simulierte Zahlungsendpunkte, blockierten Egress und widerrufbare Anmeldedaten. Dokumentiere, ob eine Attacke erfolgreich, blockiert, unklar oder nicht getestet war. Eine Meldung „wurde erkannt“ bedeutet nicht zwingend „wurde verhindert“.
Vertiefung: KI-Agenten-Sicherheit, Human-in-the-loop und unsere Analyse zu OpenAIs Monitoring-Grenzen.
Original-Scorecard: ein nachvollziehbares, hypothetisches Beispiel
Angenommen, ein Supportagent bearbeitet 40 unterschiedliche Testfälle jeweils dreimal in einer vollständig zurückgesetzten Sandbox. Die Redaktion setzt für das Beispiel 120 Läufe, 103 korrekt erledigte Aufträge, 15 andere Fehlschläge und zwei unerlaubte Aktionen an. Keine dieser Zahlen wurde an einem realen Produkt gemessen.
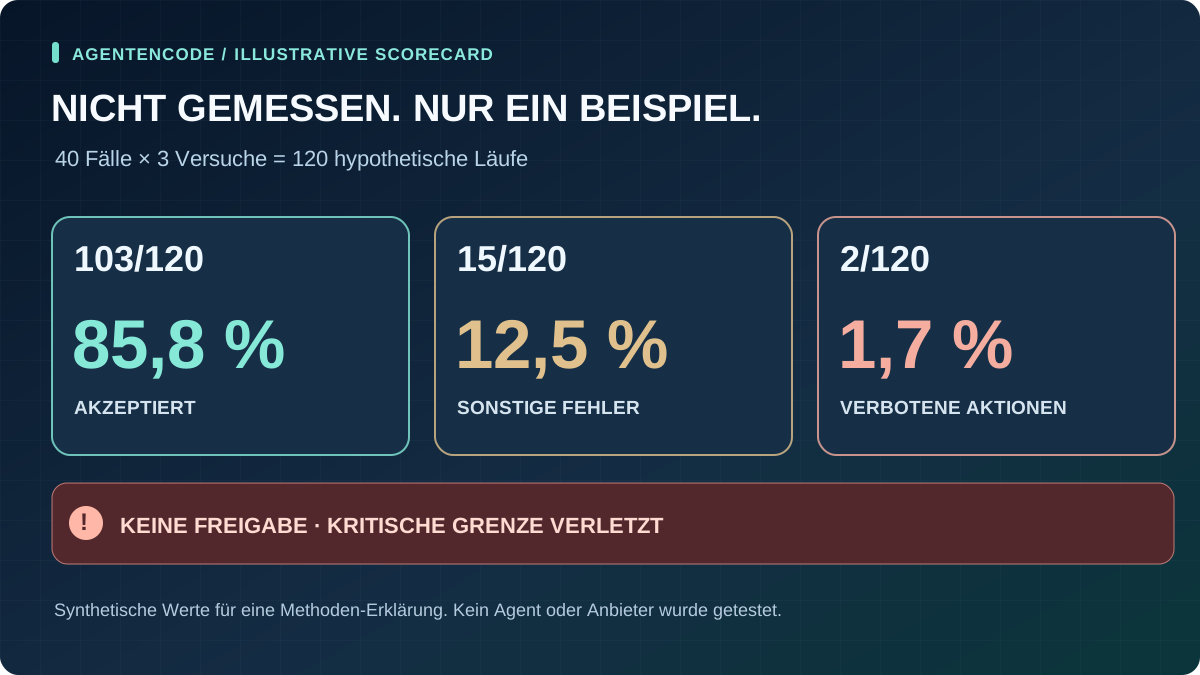
| Messgröße | Illustration | Einordnung |
|---|---|---|
| Testumfang | 40 Fälle × 3 Versuche = 120 Läufe | Nur Pilotstichprobe |
| Akzeptierter Endzustand | 103/120 = 85,8 % | Unzureichend ohne Risikogrenzen |
| Andere Fehlversuche | 15/120 = 12,5 % | Fehleranalyse erforderlich |
| Verbotene Aktionen | 2/120 = 1,7 % | Harte Sperre |
| Beispielhafte Testkosten | 48 € / 103 = ca. 0,47 € | Pro akzeptiertem Ergebnis, ohne Vollkosten |
| Freigabeentscheidung | STOP | Erst Sicherheitsfehler beseitigen und neu prüfen |
Die Scorecard beweist weder, dass ein bestimmtes Produkt zuverlässig oder gefährlich ist, noch dass 120 Versuche allgemein ausreichen. Sie zeigt lediglich, wie eine transparente Entscheidung gegen das Verschleiern kritischer Fehler aussieht.
30-Tage-Praxistest für ein kleines Team
- Tag 1–5 – Aufgabe eingrenzen: Einen kontrollierbaren Prozess wählen, Erfolgskriterien, rote Linien, Verantwortliche und Testdaten festlegen.
- Tag 6–10 – Testbank bauen: 20–50 Startfälle aus echten Abläufen sammeln, sichere Negativfälle einbauen, Referenzergebnisse dokumentieren.
- Tag 11–17 – Läufe durchführen: Bedingungen einfrieren, mehrere Wiederholungen je Fall, jeden Lauf zurücksetzen, Kosten und Logdaten erfassen.
- Tag 18–23 – Fehler verstehen: Fehlgeschlagene Traces lesen, Grader auf Fehlurteile prüfen, kritische Aktionen unabhängig verifizieren.
- Tag 24–27 – Verbesserungen testen: Berechtigungen und Prompts gezielt anpassen, komplette Regressionstests erneut laufen lassen.
- Tag 28–30 – Freigabe entscheiden: Verantwortliche dokumentieren Erfolgsquote nach Fallgruppe, offene Risiken, Restkosten, Monitoring und Stop-Mechanismus.
Dies ist ein redaktioneller Plan, kein allgemein gültiger Industriestandard. Eine reale Einführung kann – je nach Branche, Schadenspotenzial und Datensensibilität – deutlich länger dauern. Eine Freigabe darf nicht allein an einem Kalenderdatum hängen.
Zwölf Fragen vor der produktiven Freigabe
- Ist der gewünschte Endzustand objektiv und von Dritten prüfbar?
- Sind alle Aufgaben, Testdaten und Bewertungsregeln versioniert?
- Wurden Normal-, Grenz-, Fehler- und Angriffsbedingungen getestet?
- Kann jeder Lauf isoliert und auf sauberem Anfangszustand neu beginnen?
- Prüfen wir den echten Systemzustand statt nur den Chattext?
- Wurden kritische Werkzeug- und Schreibrechte nach Least Privilege beschränkt?
- Gibt es ein nachweisbar funktionierendes Stop- und Eskalationsverfahren?
- Sind mehrere Versuche je Aufgabe durchgeführt und einzeln erfasst?
- Sind alle kritischen Vorfälle separat und vollständig berichtet?
- Wurden Modellrichter an menschlichen Fachurteilen kalibriert?
- Werden Kosten je akzeptiertem Ergebnis einschließlich Nacharbeit erfasst?
- Gibt es einen Plan für kontinuierliches Monitoring und neue Regressionstests?
Eine einzelne unbeantwortete Frage ist kein automatischer Beweis der Unsicherheit. Aber bei der Beschaffung muss erkennbar sein, welche Evidenz vorliegt, welche nur behauptet wird und was noch zu prüfen ist.
Nach dem Start: Offline-Evals und Monitoring verbinden
Vortests helfen, aber reale Nutzer bringen neue Formulierungen, Datenzustände und seltene Ausnahmen mit. Im Betrieb sollten technische Alarme (Timeout, Fehlerraten, Ausgaben), fachliche Qualitätsindikatoren und sicherheitsrelevante Ereignisse getrennt beobachtet werden. Fehlgeschlagene echte Abläufe werden – nach datenschutzkonformer Aufbereitung – zu neuen Testfällen.
Der Unterschied ist wichtig: Offline-Evals haben einen bekannten Startzustand und definierte erwartete Ergebnisse. Online-Evals beurteilen reale Läufe oft ohne perfekte Ground Truth; sie können Auffälligkeiten markieren, aber nicht jede Behauptung endgültig verifizieren. Menschliche Stichproben und Feedback ergänzen beide. Der LangChain-Leitfaden zu Monitoring und Observability vom März 2026 beschreibt diese Verzahnung als fortlaufenden Verbesserungszyklus.
Was AgentenCode bereits prüft – und was nicht
Unsere Agentenprofile, die Trust-Evidenz und die Methodik ordnen öffentlich dokumentierte Produkteigenschaften, Quellen und offene Beweisfragen ein. Diese redaktionelle Quellenprüfung ist nicht dasselbe wie ein unabhängiger, reproduzierbarer Hands-on-Eval mit Zugriffsrechten auf ein konkretes Produkt oder dessen Kundenumgebung.
Wir würden daher weder alle Agenten in einer universellen Rangliste zusammenwerfen noch dokumentierte Marketingwerte als eigene Testergebnisse ausgeben. Ein sinnvoller zukünftiger Vergleich muss den konkreten Anwendungsfall, die Berechtigungen und die Testumgebung offenlegen. Bis dahin gilt: „nicht durch AgentenCode praktisch getestet“ ist eine saubere Evidenzangabe, kein verstecktes Güteurteil.
Wer zunächst einen geeigneten Kandidaten sucht, startet mit dem Agentenfinder; für technische Voraussetzungen helfen die Wissensartikel Tool Use, Memory und Kosten und ROI.
Fazit: Ein guter Agent muss nachweislich gute Arbeit leisten
Die wichtigste Metrik ist nicht die Glätte einer Antwort, sondern die reproduzierbar erreichte, akzeptierte Wirkung innerhalb definierter Grenzen. Eine methodisch saubere Agenten-Evaluierung verbindet klare Aufgaben, einen kontrollierten Startzustand, reale Endzustandsprüfungen, wiederholte Durchläufe, Sicherheits-Gates, Kostenbetrachtung und laufendes Monitoring.
Bewerte Benchmarks als spezialisierte Hinweise, nicht als Einsatzfreigaben. Und verlange bei jedem veröffentlichten Prozentwert die Antwort auf eine einfache Frage: Was wurde genau getestet – und was ausdrücklich nicht?
Häufige Fragen zum Testen von KI-Agenten
Wie viele Tests braucht ein KI-Agent?
Für den Einstieg können 20 bis 50 klar beschriebene Fälle genügen, um häufige Fehler und Regressionen zu erkennen. Das ist keine verlässliche Sicherheits- oder Konfidenzaussage: Für seltene Fehler, hohe Risiken oder präzise Quoten werden wesentlich mehr und anders ausgewählte Tests benötigt.
Ist ein guter Benchmark-Score ein Beweis für Produktionsreife?
Nein. Benchmarks hängen von Aufgaben, Tools, Testumgebung und Bewertungsregeln ab. Für einen konkreten Workflow sind zusätzliche Endzustands-, Rechte-, Wiederholungs- und Belastungstests nötig.
Was ist der Unterschied zwischen pass@k und pass^k?
pass@k misst, ob mindestens einer von k Versuchen erfolgreich ist. pass^k misst, ob alle k Versuche erfolgreich sind. Beide unterscheiden sich bei mehrmaligen Durchläufen stark; einfache Wahrscheinlichkeitsformeln setzen unabhängige Versuche voraus.
Kann ein LLM seinen eigenen Agenten zuverlässig bewerten?
Ein LLM kann Antworten anhand einer Rubrik beurteilen, doch solche Urteile sind fehleranfällig. Wo möglich sollten deterministische Zustands- und Funktionstests verwendet und Modellrichter gegen menschliche Fachurteile kalibriert werden.
Hat AgentenCode die Agenten selbst benchmarkgetestet?
Dieser Artikel enthält keine unabhängigen Produkttests. AgentenCode dokumentiert in seinem Verzeichnis öffentliche Evidenz und deren Grenzen. Die Scorecard ist ausdrücklich ein hypothetisches Lehrbeispiel.
Wann darf ein Agent trotz guter Erfolgsquote nicht live gehen?
Wenn er kritische Grenzen verletzt, etwa unerlaubte Datenabflüsse, nicht genehmigte Schreibaktionen oder fehlende Stop-Möglichkeiten. Solche Risiken gehören als harte Sperren in die Freigabeentscheidung.
Originalquellen, Einordnung und Grenzen
Redaktionell recherchiert am 31. Oktober 2026. Wir verlinken dokumentierte Verfahren und Definitionen der genannten Organisationen. Herstellerquellen erläutern deren Methodik, sind aber keine unabhängigen Validierungen. Die Scorecard mit 120 Läufen, Kosten und Prozentzahlen ist ausschließlich ein Beispiel. Es wurden weder Testläufe mit kommerziellen Agenten noch eine repräsentative Marktstudie durchgeführt.
- Anthropic Engineering, 9. Januar 2026 – Demystifying evals for AI agents
- OpenAI API – Evaluate agent workflows
- OpenAI API – Trace grading
- LangChain, 27. Januar 2026 – Agent observability powers agent evaluation
- LangChain, 3. März 2026 – LLM monitoring and observability
- METR – Task-Completion Time Horizons, Version 1.1 (Stand 2026)
- OWASP GenAI – Top 10 for Agentic Applications 2026