
BioBasicsBench: GPT-6 Astra erreicht 66,7 % – doch Laborkontrollen bleiben kritisch
OpenAI und Ligo testen die Interpretation von Labor-Rohdaten: GPT-6 Astra erzielt 66,7 % Rubrikpunkte, scheitert aber teils an wichtigen Entscheidungen.
1. Eine andere Art Agenten-Benchmark
Wissenschaftliche Fachpublikationen zeigen meist ausgewählte, aufbereitete Messungen. Im Labor selbst begegnen Forschenden beschädigte, falsch beschriftete, unvollständige und widersprüchliche Daten. BioBasicsBench verwendet deshalb Gelbilder, Mikroskopieaufnahmen, Instrumentexporte, Notizen und Laborvideos. Die 100 Aufgaben verteilen sich auf Proteinmethoden, Bildgebung/Zytometrie, Quantifizierung/Assays, Nukleinsäuremethoden und molekulares Klonieren. Wissenschaftler entwickelten die Aufgaben aus Experimenten und überprüften die Kriterien intern und extern. Bewertet werden fachliche Antworten und die Fähigkeit, unzureichende Beweise zu erkennen, nicht die Ausführung physischer Experimente.
2. Zahlen korrekt lesen
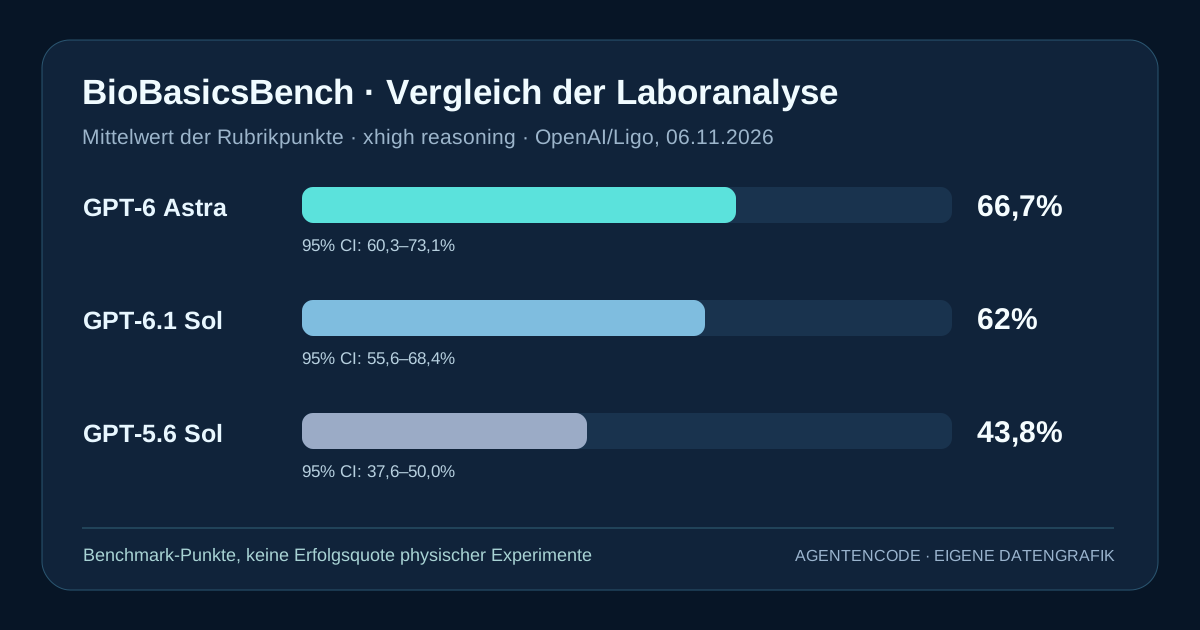
| Modell bei xhigh | Mittlere Rubrikpunkte | 95-%-Intervall | Ausgabetokens je Aufgabe |
|---|---|---|---|
| GPT-6 Astra | 66,7 % | 60,3–73,1 % | 4.704 |
| GPT-6.1 Sol | 62,0 % | 55,6–68,4 % | 5.238 |
| GPT-5.6 Sol | 43,8 % | 37,6–50,0 % | 9.099 |
Die Messgröße ist ein anteiliger Bewertungsscore, keine binäre Erfolgsquote pro Experiment. OpenAI berichtet sieben Modelle, 37 Modell/Effort-Konfigurationen, fünf Versuche je Aufgabe und insgesamt 18.500 Antworten. Die Vertrauensintervalle stammen aus einem Bootstrap über ganze Aufgaben. AgentenCode hat die Versuche nicht unabhängig wiederholt. Das ist ein spezieller Testdatensatz mit 100 Aufgaben und keine allgemein gültige Aussage zu Laborautomation oder Patientensicherheit.
3. Der große Fortschritt: Ungültige Kontrollen bemerken
In einem von OpenAI beschriebenen Klonierungsversuch las GPT-6 Astra den Aufdruck „LB Kan50“ auf einer vermeintlichen Negativkontrolle. Die Platte enthielt laut Markierung Kanamycin; das Experiment erforderte Ampicillin. Astra erkannte deshalb, dass diese Kontrolle kein verlässlicher Beleg ist. Das ältere Modell deutete die leere Platte fälschlich als Aussage zum Experiment.
AgentenCode-Analyse: Ein Agent darf nicht nur den gemessenen Wert auslesen. Er muss vor jeder Folgerung fragen, ob Herkunft, Einheit, Kontrollgruppe, Beschriftung und Messbedingung stimmen. Dieser Mechanismus lässt sich auf Sicherheitslogs, Finanzdaten und Governance-Berichte übertragen.
4. Der ernüchternde Fehler: Muster erkannt, falsche Kolonien gewählt
Die Veröffentlichung nennt ausdrücklich Gegenbeispiele. Bei einer PCR-Analyse erkannte Astra Gruppen von Banden, ordnete sie aber falsch zu. Es empfahl Kolonien 4, 6, 7, 8, während der Referenzbefund 5, 9, 10 auswählte. In einem weiteren Fall überschätzte es Kolonien um ungefähr 12 %. Das zeigt: Korrekte Wahrnehmung einzelner Signale bedeutet nicht, dass die finale Handlungsempfehlung stimmt.
5. Eigene Go/No-Go-Entscheidungsmatrix
| Einsatz | AgentenCode-Urteil | Notwendige Kontrolle |
|---|---|---|
| Rohdaten strukturieren | Beaufsichtigter Pilot | Originalmaterial aufbewahren |
| Fehlende oder falsche Kontrolle markieren | Beaufsichtigter Pilot | Protokoll und Labels verifizieren |
| Messwerte/Kolonien zählen | Nur mit Gegenprüfung | Referenz und Unsicherheit prüfen |
| Nächsten Versuch vorschlagen | Nur Vorschlag | Fachliche Freigabe |
| Eigenständige risikorelevante Laboraktion | No-Go auf Basis dieser Evidenz | Separater Praxis-/Sicherheitsnachweis und Freigabe |
Diese Matrix ist eine redaktionelle Schlussfolgerung, kein Herstellerzertifikat. Besonders wichtig ist die Trennung von Wahrnehmung, Interpretation und Handlung: Ein Agent sollte nicht handeln, wenn Kontrollen widersprüchlich sind.
6. Was Entwickler daraus lernen
Ein zuverlässiger Agenten-Workflow benötigt getrennte Prüfschritte: erst Rohdaten und Quelle speichern, dann Kontrollen/Einheiten validieren, anschließend mindestens eine alternative Erklärung prüfen, Unsicherheit dokumentieren und zuletzt Aktionen separat autorisieren. Falsche Endentscheidungen trotz korrekt erkannter Teilmuster verdienen eine eigene Fehlermetrik. Eine reine Anzahl richtiger Antworten verdeckt solche Fehler.
7. Status, Grenzen und Quellen
Der Bericht vom 6. November 2026 ist OpenAIs eigene Benchmark-Veröffentlichung in Kooperation mit Ligo. Eine externe Bewertung einzelner Aufgaben ist keine unabhängige Replikation sämtlicher Modellwerte. Keine hier beschriebene Zahl beweist die sichere Durchführung realer Laborarbeiten oder eine Zulassung für klinische Anwendungen. Ein allgemeiner kommerzieller Laboragent, sein Preis oder regionaler Rollout werden dadurch nicht bestätigt.
FAQ
Sind 66,7 % die Quote korrekt abgeschlossener Experimente? Nein, es sind durchschnittliche Rubrikpunkte über Dateninterpretationsaufgaben.
Wurde ein Laborroboter getestet? Nein, die Untersuchung bewertet Antworten auf Labor-Rohdaten.
Warum ist das Beispiel mit der Kontrolle wichtig? Ohne verlässliche Kontrolle ist selbst eine präzise Bildanalyse wertlos.
Darf Astra Entscheidungen ungeprüft treffen? Diese Freigabe wird durch die Studie nicht belegt.
Originalquelle und Prüfhinweis
OpenAI: Measuring how AI agents handle everyday wet-lab science (06.11.2026). Alle Zahlen und Fälle sind Anbieterangaben; Matrix und Konsequenzen sind eigene AgentenCode-Analyse. Kein eigener Labortest, keine unabhängige Messung, keine Sicherheitszertifizierung.
Primärquellen und Einordnung
Echte Primärquellen, eigene redaktionelle Analyse. Keine unabhängige Replikation, kein Agenten-Sicherheitszertifikat und keine allgemeinen Verfügbarkeits- oder Kostengarantien.