
KI-Agenten im Linux-Kernel: 948 Root-Exploits – aber noch keine 948 Patches
OpenAI berichtet von 948 unterschiedlichen Linux-Kernel-LPEs. Warum unabhängige Ursachenprüfung, Human Review und Patch-Merge wichtiger sind als die Schlagzeilenzahl.
OpenAI berichtet von 948 unterschiedlichen Linux-Kernel-LPEs. Warum unabhängige Ursachenprüfung, Human Review und Patch-Merge wichtiger sind als die Schlagzeilenzahl.
Quellenlage und Grenzen
- Primärquelle
- Redaktionelle Auswertung, kein Test
Quellen aus einer Herstellerveröffentlichung; keine unabhängigen Agententests, Penetrationstests oder Vertragsprüfungen. Status und Geltungsbereich sind zum Veröffentlichungsdatum begrenzt.
1. Fünf Zahlen, fünf verschiedene Aussagen
Die automatisierte Suche begann laut Originalbericht mit 5.034 Audit-Zielen und rund 2,8 Millionen Codezeilen – ungefähr sieben Prozent des untersuchten Kernel-Codes. Agenten erstellten anschließend 2.308 deduplizierte Befundkandidaten. Davon wurden 1.724 Schwachstellen dynamisch reproduziert. Als besonders relevante Teilmenge meldet OpenAI 948 funktionierende LPE-Exploits und zusätzlich 291 Proofs of Concept für Informationslecks. Die Mengen bezeichnen unterschiedliche Prüfschritte; sie dürfen nicht addiert werden.
Der Scan lief Mitte Oktober 2026 in einer kontrollierten Umgebung gegen eine damals aktuelle Kernel-Version. Dass eine Schwachstelle im Forschungsaufbau funktioniert, sagt noch nicht, ob sie heute auf einem konkret gepatchten Host vorhanden ist. Für Unternehmen zählt deshalb die Zuordnung zur betroffenen Version, zum tatsächlich genutzten Kernel-Konfigurationspfad und zu den bereits eingespielten Fixes.
2. Vom Scout zum Patch: Arbeitsteilung der Agenten
Scout-Agenten identifizieren potenziell sicherheitskritische und von wenig privilegierten Prozessen erreichbare Kernel-Teile. Analyst-Agenten prüfen diese Ziele auf plausible Fehler. Danach folgen dynamische Reproduktion in isolierten Umgebungen, Nachweis einer konkreten Ausnutzbarkeit, Root-Cause-Analyse und die Erstellung eines Patch-Kandidaten. Am Ende stehen menschliche Sicherheitsforscher, die Befund, Angriffsweg und Patch bewerten und mit den Maintainer-Prozessen abstimmen.
Diese Rollenarchitektur ist redaktionell wichtig: „autonom“ bedeutet hier nicht, dass der Agent selbstständig einen Kernel-Fix in ein öffentliches Upstream-Repository merged. Die privilegierte Freigabegrenze bleibt bei Menschen und Projekt-Maintainern. Die Grafik im finalen Beitrag soll genau diese Grenze zwischen maschineller Ausführung und menschlichem Merge-Gate zeigen.
3. Ein erfolgreiches Ergebnis kann die falsche Ursache haben
Die Originalquelle schildert einen aufschlussreichen Messfehler: In einer frühen Stichprobe von 200 als erfolgreich gezählten LPEs nutzten 20 nicht die ihnen zugewiesene Sicherheitslücke, sondern einen anderen Zero-Day. Der Root-Shell-Test war positiv, die Zuordnung zum behaupteten Befund aber falsch. Erst eine unabhängige Prüfung des tatsächlichen Ausnutzungspfads schloss diese Lücke.
AgentenCode-Folgerung: Agentenbewertung muss neben der Frage „War die Aufgabe erfolgreich?“ auch „Wurde sie mit dem behaupteten Mechanismus und den erlaubten Rechten erledigt?“ beantworten. Diese Unterscheidung gilt ebenso für Coding-Agenten, Datenbank-Operationen und automatisierte Remediation. Erfolgsmetriken ohne Ursachenbeleg fördern stille Fehlklassifikation.
4. Was die 1,2 Millionen Dollar aussagen – und was nicht
OpenAI beziffert den beschriebenen Versuch auf 1.213.430 Dollar API-Credits, entsprechend etwa 1.279 Dollar je berichteten LPE-Exploit. Der Anbieter vergleicht den Betrag mit historischen Bug-Bounty-Prämien von 20.000 bzw. 70.000 Dollar und konstruiert hypothetische Werte von 18,9 bis 66,3 Millionen Dollar. Dies ist eine Szenariorechnung, kein real erzielter Auszahlungsbetrag und keine garantierte Rendite: Bounty-Regeln, Duplikate, Priorität, Reproduzierbarkeit und Offenlegung reduzieren den monetarisierbaren Anteil.
Für Verteidiger ist eine andere Rechnung nützlicher: Kosten je validiertem, noch nicht behobenem und im eigenen Bestand relevantem Fehler, einschließlich menschlicher Review-Kosten, wiederholter Tests und Patch-Rollout. Nur diese Größe kann die Wirtschaftlichkeit eines produktiven Security-Agenten-Programms sinnvoll messen.
5. Der Patch- und Disclosure-Engpass bleibt menschlich
OpenAI berichtet, dass während der Untersuchung mehrere Dutzend LPEs bereits upstream korrigiert oder als Patches vorbereitet waren. Das zeigt, warum automatisches Nachtesten gegen aktuelle Branches und eine deduplizierte Meldung an Maintainer nötig sind. Neue KI-Agenten können Schwachstellenforschung beschleunigen, aber verantwortliche Offenlegung und Patch-Qualität nicht überspringen.
Eine belastbare Unternehmenspraxis benötigt isolierte Testinfrastruktur, dokumentierte Autorisierung, Versionierung von Testumgebungen, ein Ticket je einzigartigem Befund, reproduzierbare Ursache, Freigabe durch unabhängige Fachpersonen und Rollback-Möglichkeiten. Hierzu reichen öffentlich verfügbare Blogzahlen als Sicherheitsnachweis nicht aus.
6. AgentenCode-Entscheidungsmatrix: vom Fund zum sicheren Fix
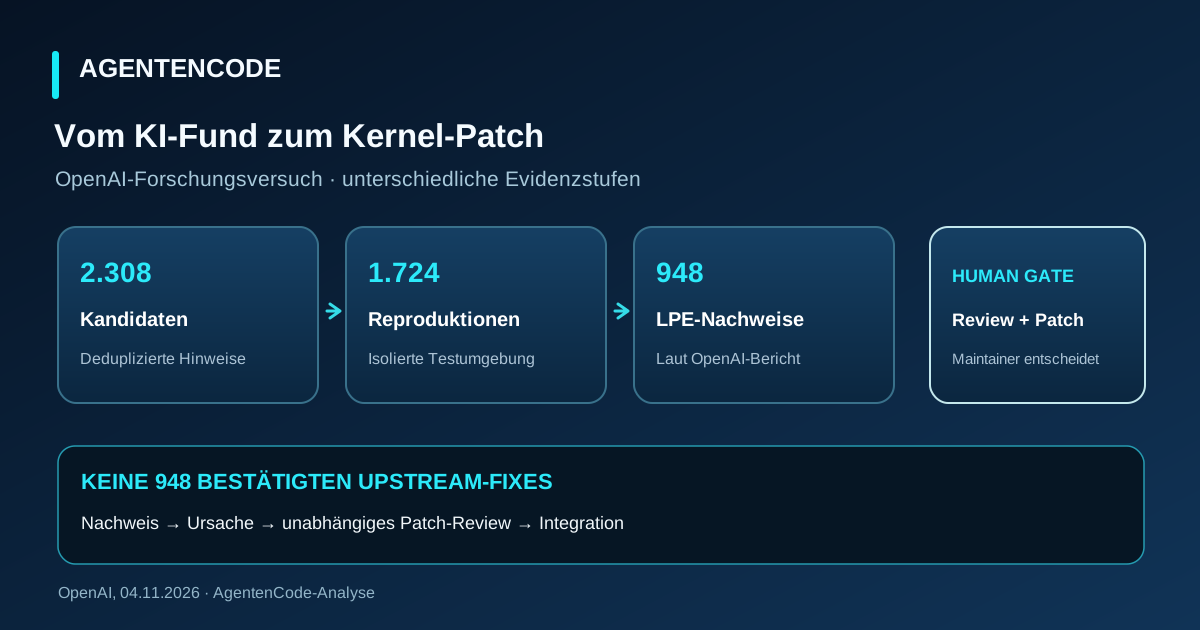
| Stufe | Herstellerbeleg | Erforderliches Freigabe-Gate | Was noch unbewiesen bleibt |
|---|---|---|---|
| Audit-Ziel | 5.034 ausgewählte Ziele | Erlaubter Code-/Scope-Zugriff | Abdeckung des gesamten Systems |
| Kandidat | 2.308 deduplizierte Hinweise | Reproduktionsplan und Ownership | Echte Ausnutzbarkeit |
| Reproduktion | 1.724 dynamisch reproduziert | Isolierte, zugelassene Testumgebung | Root-Eskalation |
| LPE-Nachweis | 948 funktionierende LPE-Exploits laut OpenAI | Unabhängige Ursachenprüfung | Übertragbarkeit auf andere Kernel |
| Patch-Vorschlag | Candidate Patch mit Root Cause | Maintainer-Review, Tests, Rollback | Upstream-Merge und Flächenwirkung |
Redaktionelle Matrix: Die Werte stammen ausschließlich aus dem OpenAI-Bericht, das Gate-Modell ist unsere eigene Einordnung. Ein begleitendes SVG zeigt den Fluss und die menschliche Stop-Linie, keine Exploit-Anleitung.
7. Die größere Entwicklung: Autonomie braucht unabhängige Beweise
Die bemerkenswerteste Aussage dieser Untersuchung ist nicht, dass KI-Agenten Schwachstellen „finden können“. Entscheidend ist, dass viele spezialisierte Agentenschritte zu einer gemeinsamen, messbaren Sicherheitsforschungskette verbunden wurden. Dieselbe Architektur kann Verteidigern helfen – sie erhöht aber zugleich die Anforderungen an Authentisierung, Isolierung, Datenherkunft und sichere Veröffentlichung.
Für Open-Source-Maintainer entsteht ein zweischneidiger Effekt: mehr überprüfbare Hinweise können die Sicherheit stärken, aber ungefilterte automatische Reports können begrenzte Review-Kapazität überlasten. Das Differenzierungsmerkmal vertrauenswürdiger Security-Agenten wird deshalb die Qualität bestätigter, erklärter, priorisierter und tatsächlich eingespielter Fixes sein – nicht die Anzahl erzeugter Reports.
FAQ
Hat OpenAI 948 Linux-Sicherheitslücken bereits geschlossen?
Nein. OpenAI berichtet von 948 funktionierenden LPE-Exploits und generierten Patch-Kandidaten. Eine vollständige Upstream-Integration dieser Zahl ist nicht belegt.
Sind Linux-Server dadurch automatisch kompromittiert?
Nein. Die Untersuchung betraf spezifische Kernel- und Testumgebungen; welche Konfigurationen und Patchstände im einzelnen Betrieb betroffen sind, muss separat festgestellt werden.
Kann ich die Pipeline selbst verwenden?
Die Veröffentlichung beschreibt ein Forschungsprototyp mit einem kommenden Cybermodell, keine allgemein verfügbare Standardfunktion mit bestätigtem Preis und Produktzugang.
Was sollten Unternehmen jetzt prüfen?
Aktuelle Kernel-Updates, isolierte Testumgebungen, Verantwortlichkeiten für Disclosure/Patches und die unabhängige Verifikation jeder KI-generierten Sicherheitsbehauptung.
Methodik, Interessen und weiterführende Einordnung
Dieser Beitrag wurde mit KI-Unterstützung redaktionell erstellt und anhand der Originalveröffentlichung vom 04.11.2026 auf bekannte Fakten- und Geltungsgrenzen geprüft; wir haben die Pipeline nicht betrieben, keine Schwachstellen reproduziert und keine Exploits getestet. OpenAI ist sowohl Urheber der Forschung als auch Anbieter der verwendeten Modelle. Die im Beitrag genannten Messwerte sind Herstellerangaben, nicht unabhängige AgentenCode-Messungen.
Primärquelle: https://openai.com/index/a-thousand-fewer-paths-to-root/
AgentenCode-Kontext: AgentenCheck, AgentenTrust, sowie bestehende Analysen zu formaler Verifikation und Sicherheit autonomer Coding-Agenten. Interne Ziel-URLs und endgültige Veröffentlichungstermine erst bei echtem Live-Gate einsetzen.