
Pando: OpenAI baut Git für Codex-Agenten um – fast 80 Prozent kürzere Push-Zeiten
Viele parallel arbeitende KI-Coding-Agenten verändern nicht nur die Menge des geschriebenen Codes, sondern auch die Last auf Git-Servern. Am 2. November 2026 stellte OpenAI Pando vor: einen neuen, Git-kompatiblen Backend-Dienst, der Branch-Updates und Datenabrufe anders organisiert. Laut OpenAI ist die mittlere Push-Latenz in seiner eigenen Produktion dadurch um fast 80 Prozent gesunken.
Pando verarbeitet Git-Pushes zu unterschiedlichen Branches unabhängig und stellt wiederverwendbare Packfiles über Caches bereit. OpenAI nennt nahezu fünfmal schnellere Median-Pushes sowie fast ein Petabyte Git-Datentransfer täglich. Das sind berichtete interne Produktionswerte – weder ein unabhängiger Benchmark für andere Repositories noch eine Ankündigung, dass Pando heute allgemein als Produkt verfügbar ist.
Quellenlage und Grenzen
- Primärquelle
OpenAIs ausführlicher Engineering-Bericht vom 2. November 2026 erläutert Architektur, Produktionsmesswerte und Trade-offs. Original lesen.
- Nicht unabhängig geprüft
Keine unabhängige Performance-Replikation und keine bestätigte öffentliche Pando-GA, Preis- oder Verfügbarkeitszusage.
Warum viele Codex-Agenten Git unter Druck setzen
Wenn ein Entwickler mehrere Codex-Sitzungen parallel laufen lässt, entstehen mehr Branches, Pushes, Fetches, CI-Starts und Merge-Versuche. Diese Last verstärkt sich gegenseitig: Ein Push kann viele Builds auslösen, die dieselben Objekte erneut herunterladen. OpenAI berichtet, dass sein großes Monorepo dadurch zunehmend langsam wurde; die Zuverlässigkeit von Merges fiel phasenweise unter 90 Prozent.
Das ist eine bemerkenswerte Verschiebung gegenüber der üblichen Debatte um Tokens und Modellgeschwindigkeit. Ein schnellerer Coding-Agent nützt wenig, wenn Source Control, CI und Review zum Engpass werden. OpenAI hat deshalb nicht die vertrauten Git-Kommandos ersetzt, sondern einen anderen Server-Unterbau gebaut. Bestehende Git-Clients und gewohnte Workflows sollen weiter funktionieren.
Wie Pando parallele Branch-Updates ermöglicht
Konventionelle Git-Dienste können Aktualisierungen über Repository-Replikate koordinieren und damit selbst unabhängige Branch-Pushes auf einen gemeinsamen Synchronisationspunkt zwingen. Pando verwaltet die Referenzen branchweise. Unabhängige Branches können parallel fortgeschrieben werden; konkurrierende Änderungen derselben Referenz bleiben geordnet und werden atomar geprüft.
Der Preis dieses Designs ist eine schwächere, kausale Konsistenz über das gesamte Repository. Wer mehrere Branches gleichzeitig abfragt, erhält nicht zwingend einen einheitlichen Schnappschuss exakt desselben Zeitpunkts. Für einen Agenten, der den Stand seines eigenen Branches liest, kann das ausreichend sein. Wer dagegen eine globale Sicht über mehrere Refs verlangt, muss diese Grenze bewusst berücksichtigen.
Warum wiederverwendbare Packfiles wichtig sind
Git überträgt Dateien, Historien und Änderungen typischerweise als komprimierte Packfiles. Pando bewahrt eingehende Packs als unveränderliche Objekte auf und verknüpft sie mit versionierten Ref-Metadaten. Beim Abruf wählt der Dienst bereits gespeicherte Packs aus, statt für jeden Client dieselbe Historie neu zusammenzustellen. Git-kompatible Packfile-URIs erlauben mehrere Downloads über normale Cache-Infrastruktur.
Das System verschiebt Arbeit vom wiederholten Komprimieren in die Auswahl, Zwischenspeicherung und Verdichtung von Packs. OpenAI beschreibt regionale Caches mit über 99 Prozent Trefferrate und Fetches, die 10-Gbit/s-Netzwerkverbindungen auslasten können. Der Nutzen hängt aber von parallelen Abrufmustern und Cache-Wiederverwendung ab; ein kleines Projekt ohne solche Last muss nicht dieselben Vorteile sehen.
Welche Leistung OpenAI tatsächlich gemessen hat
Der Engineering-Beitrag nennt beinahe fünfmal schnellere Median-Pushes und fast 80 Prozent kürzere mittlere Push-Latenz nach dem Wechsel. Pando transportiert nach OpenAIs Angaben nahezu ein Petabyte Git-Daten am Tag; mehr als 57 Terabyte Packs seien in einer einzelnen Stunde ausgeliefert worden. Diese Werte stammen aus dem beschriebenen OpenAI-Betrieb und sind keine herstellerübergreifende Messreihe.
OpenAI schreibt, Pando sei mit Codex in rund zehn Wochen von Projektbeginn zur Produktion gekommen. Dabei wurden deterministische Simulationen, Konformitätstests und formale Methoden eingesetzt, um Nebenläufigkeit und Korrektheit zu prüfen. Für Leser ist nicht nur das Tempo wichtig, sondern das Zusammenspiel von überprüfbaren Invarianten, Team-Review und schrittweiser Migration.
AgentenCode-Matrix: Das sind die Architektur-Trade-offs
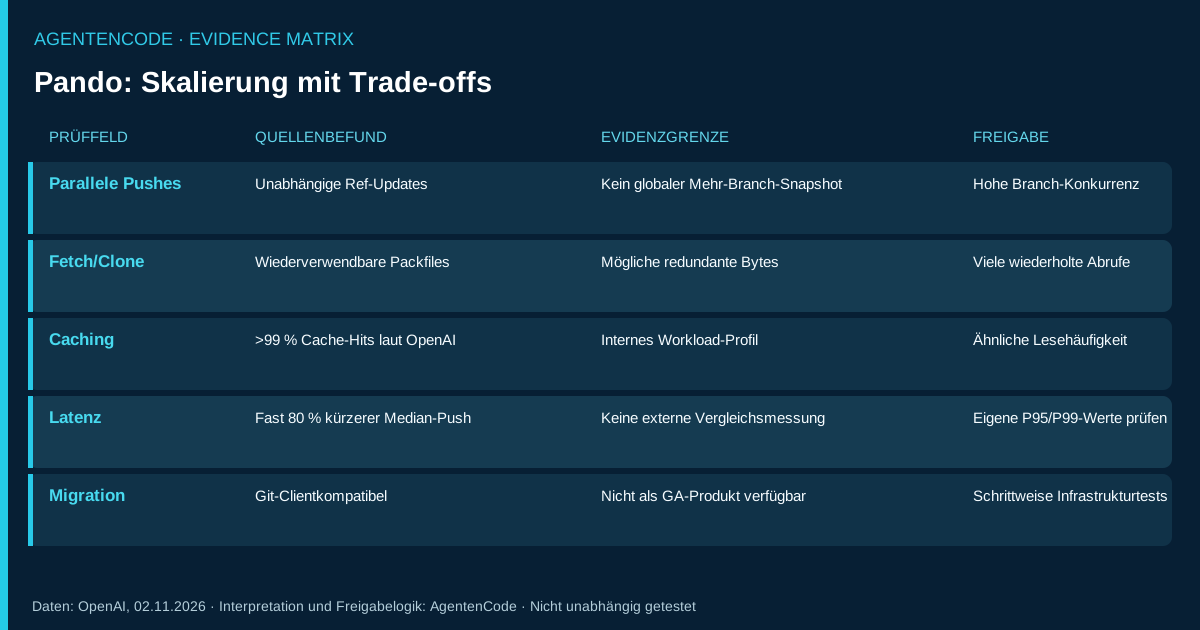
Unsere Entscheidungsmatrix ordnet die berichteten Eigenschaften danach, wann sie helfen und welche Kompromisse sie mit sich bringen. Das ist eine eigenständige Analyse der veröffentlichten Architektur, keine von AgentenCode gemessene Leistungszahl.
Besonders relevant ist die Konsistenzentscheidung: Wer Refs unabhängig aktualisiert, gewinnt Parallelität, kann aber keine atomare Momentaufnahme aller Branches voraussetzen. Wer Packs stark wiederverwendet, spart Rechenarbeit, kann jedoch zusätzliche Bytes übertragen. Die richtige Wahl hängt vom eigenen Repository und dem realen Lastprofil ab.
| Fall | Quellenbefund | Offene Prüfung | Freigabepunkt |
|---|---|---|---|
| Parallele Pushes | Unabhängige Ref-Updates | Kein globaler Mehr-Branch-Snapshot | Hohe Branch-Konkurrenz |
| Fetch/Clone | Wiederverwendbare Packfiles | Mögliche redundante Bytes | Viele wiederholte Abrufe |
| Caching | >99 % Cache-Hits laut OpenAI | Internes Workload-Profil | Ähnliche Lesehäufigkeit |
| Latenz | Fast 80 % kürzerer Median-Push | Keine externe Vergleichsmessung | Eigene P95/P99-Werte prüfen |
| Migration | Git-Clientkompatibel | Nicht als GA-Produkt verfügbar | Schrittweise Infrastrukturtests |
Was andere Teams heute daraus lernen können
Pando ist laut OpenAI intern im Einsatz, aber die Veröffentlichung enthält keine allgemein verfügbare Produktfreigabe mit Preisliste. Teile der Git-Client-Verbesserungen wurden upstream eingebracht; das ist nicht dasselbe wie eine offene Bereitstellung des gesamten Pando-Backends. Für Unternehmen ist es daher verfrüht, einen direkten Umstieg oder einen garantierten Performance-Gewinn einzuplanen.
Praktisch sinnvoll ist ein dreistufiger Check: Erstens Push-, Fetch-, Clone- und Merge-Latenzen pro Agentenlauf erfassen. Zweitens CI-Duplikate, Cache-Hitrate und gleichzeitige Branch-Änderungen messen. Drittens Repository-Prozesse, Rechte und Review-Grenzen so gestalten, dass Parallelisierung keine ungeprüften Änderungen in den Hauptbranch bringt. Damit beginnt eine belastbare Infrastrukturentscheidung ohne Pando-Zugang.
Fazit: Agenten skalieren auch die Infrastruktur
Die Nachricht zeigt einen neuen Skalierungseffekt des Agentenzeitalters: Coding-Agenten erzeugen nicht nur Code, sie vervielfachen gleichzeitige Operationen auf gemeinsam genutzten Systemen. Source Control muss deshalb auch bei vielen aktiven automatisierten Autoren schnell, nachvollziehbar und sicher bleiben.
Unsere Einordnung: Pando ist ein aufschlussreicher Architekturbericht und ein starkes internes Betriebssignal. Es ist weder der Beweis, dass Git als Standard ungeeignet ist, noch ein universeller Leistungsbenchmark. Teams sollten zuerst ihre eigenen Engpässe messen und offen dokumentieren, welche Konsistenzgarantien ihre Agenten-Workflows tatsächlich benötigen.
Originalquellen
- OpenAI, Scaling Git at OpenAI (2 November 2026) – offizielle Erstveröffentlichung und Bezugsquelle der beschriebenen Angaben.
Häufige Fragen
Ist Pando ein neues Git-Programm, das jeder installieren kann?
OpenAI beschreibt einen intern produktiv eingesetzten, Git-kompatiblen Backend-Dienst. Eine allgemeine Produktfreigabe wird nicht angekündigt.
Was bedeutet fast 80 Prozent weniger Push-Latenz?
Das ist ein von OpenAI gemeldeter Medianwert im eigenen Monorepo nach der Umstellung, keine garantierte Verbesserung für fremde Repositories.
Müssen Entwickler auf normale Git-Kommandos verzichten?
Nein. OpenAI berichtet ausdrücklich von Git-Protokoll- und Client-Kompatibilität, weist aber auf Konsistenz-Trade-offs im Backend hin.