
Perplexity Agent API: Recherche fast 90 % günstiger – wann sich „Ultra“ wirklich lohnt
Perplexity hat am 5. November seine Agent API neu abgestimmt. Alle sogenannten Effort-Stufen sollen bei gleicher oder besserer Recherchequalität weniger kosten; neu ist „ultra“, bei dem drei Rechercheagenten parallel arbeiten und ein vierter ihre Befunde zusammenführt. Klingt nach einem einfachen Upgrade – ist aber eine wichtige Architekturentscheidung: Je komplexer der Agent, desto stärker wirken sich Werkzeugbudgets, Kontextmanagement, Quellenprüfung und Ausfallbehandlung auf die Gesamtkosten aus.
Was am 5. November wirklich neu wurde
Die Effort-Stufen der Perplexity Agent API sind vorkonfigurierte Kombinationen aus Modell, Recherche- und Toolbudget, Suchverhalten und weiteren Laufzeitparametern. Entwickler müssen also nicht für jede Aufgabe einen kompletten Recherche-Harness aufbauen. Laut Hersteller wurden alle Stufen günstiger und mindestens gleich gut; die Konfiguration jeder Stufe kann sich über die Zeit ändern.
Neu hinzugekommen ist „ultra“. Dieses Niveau soll keine schneller beantworteten Alltagsfragen ersetzen, sondern umfangreiche, mehrteilige Recherchen mit widersprüchlichen oder breit gestreuten Quellen bewältigen.
Ein Detail mit praktischen Folgen: Wer lediglich einen Effort-Namen wie „medium“ angibt, bekommt künftig automatisch dessen aktuelle Konfiguration. Wer stabile reproduzierbare Ergebnisse benötigt, sollte die Versions-Pinning-Option der Dokumentation prüfen, Änderungen protokollieren und die eigene Evaluation neu durchführen.
Die Zahlen: 55 auf 77 Prozent – und die Kostenfrage
| Herstellerangabe | Vorher | Nachher | Einordnung |
|---|---|---|---|
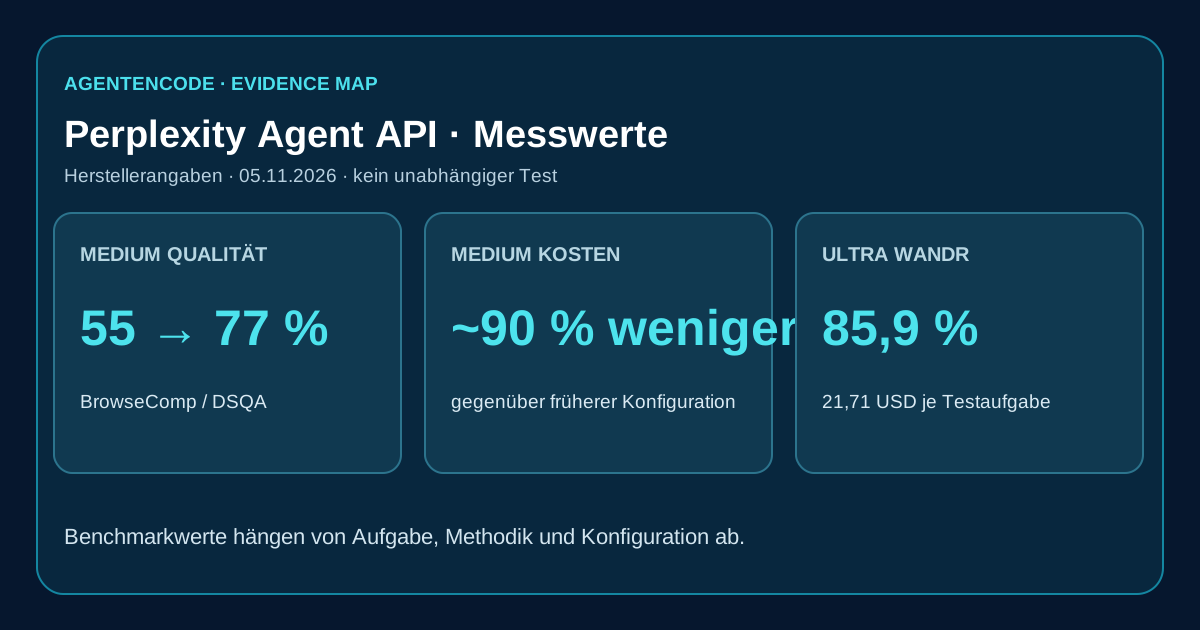
| „medium“ auf BrowseComp/DSQA | 55 % | 77 % | Plus 22 Prozentpunkte; gilt für diese Tests, nicht für jeden Einsatz |
| Kosten von „medium“ | Referenz der älteren Konfiguration | nahezu 90 % niedriger | relativer Effekt; kein universeller Preis pro Anfrage |
| „xhigh“ auf WANDR | – | 76,5 % | laut Anbieter mit etwa einem Viertel der August-Kosten |
| „ultra“ auf WANDR | – | 85,9 % | 21,71 USD je gemessener Benchmarkaufgabe |
| High mit Extraktion | 83,5 % bei $0,094 | 88,0 % bei $0,073 | Vergleich innerhalb der genannten Testkonfiguration |
Diese Werte sind Herstellerangaben. Insbesondere WANDR ist Perplexitys eigener Benchmark für lange Rechercheaufgaben. AgentenCode hat weder die Tests unabhängig nachgestellt noch den tatsächlichen Preis einer Nutzeranfrage gemessen.
Zudem zeigen die Ergebnisse eine wichtige Erkenntnis: Die höchste Punktzahl ist nicht automatisch die beste betriebswirtschaftliche Wahl. Wer Hunderte einfache Entscheidungen pro Tag trifft, kann mit „fast“ oder „medium“ wirtschaftlicher arbeiten als mit einer komplexen Vier-Agenten-Recherche.
Warum parallele Agenten sowohl helfen als auch teuer werden
Bei „ultra“ recherchieren drei Agenten dieselbe umfangreiche Aufgabe unabhängig voneinander. Ein vierter führt die Ergebnisse zusammen, entfernt Dubletten und schreibt die Antwort. Das ist eine interessante Abweichung von einem System, das nur die Aufgaben auf mehrere Teilagenten aufteilt: Verschiedene Recherchepfade können Quellenfehler, blinde Flecken und widersprüchliche Befunde sichtbar machen.
Die Grenze ist ebenso klar: Drei parallele Rechercheläufe verbrauchen mehr Suche, Kontext und Rechenarbeit als ein einzelner Lauf. Ein vierter Agent zur Synthese kostet zusätzlich. Perplexity veröffentlicht hierfür ein konkretes WANDR-Kostenbeispiel – aber keine Garantie, dass sich diese 21,71 Dollar auf beliebige produktive Aufgaben übertragen lassen.
AgentenCode-Einordnung: Vor einem Ultra-Pilot sollten Betreiber festlegen, wann eine Antwort mehr wert ist als eine schnelle Recherche: etwa bei einer komplexen Anbieter- oder Vertragsprüfung, einer sorgfältigen Marktübersicht oder einer Analyse über mehrere technische Dokumentationen. Bei „Ist Feature X schon GA?“ ist vierfaches Recherchieren in der Regel unnötig.
Die eigentlichen Kostenbremsen sind Werkzeug- und Kontextbudgets
Perplexity beschreibt fünf Ursachen für teure Agentenläufe: unklare Budgets, überladene Kontexte, falsch ausgewählte Workflows, unpassende Modellwahl und unnötige Parallelisierung. Die aktualisierten Stufen begrenzen deshalb nicht nur die Zahl von Schritten, sondern auch die Tool-Aufrufe. Das ist wichtig, weil ein einziger Modellschritt mehrere parallele Aktionen auslösen kann.
Der Anbieter illustriert diesen Zusammenhang mit einem Versuch: Steigt ein Schrittbudget von 1 auf 15, verbessert sich die untersuchte Benchmarkqualität von 41 auf 80 Prozent, während der gemessene Preis von 0,0017 auf 0,0152 US-Dollar wächst – knapp neunmal so teuer bei ungefähr doppelter Punktzahl.
Ein weiteres Beispiel betrifft die Verarbeitung langer Webseiten. Eine interne Extraktionsstufe reduzierte in einem Versuch einen Seiteninhalt von 5.561 auf 293 Token, indem nur aufgabenrelevante Passagen weitergegeben wurden. In den Tests verbesserte das nicht nur die Kosten, sondern auch die Antwortqualität. Für hochwertige Recherche bleibt allerdings wichtig, dass Originalpassagen und Quellen vollständig nachvollziehbar sind.
Skills, Checkpoints und die unsichtbare Qualität eines guten Harness
Perplexity setzt auf progressive Skills: Der Agent erhält zunächst nur die Bezeichnung einer Fähigkeit und lädt deren vollständige Anleitung erst, wenn sie für die Aufgabe benötigt wird. Das verhindert, dass umfangreiche Workflow-Anweisungen jeden Schritt verteuern.
In einem dokumentierten WANDR-Beispiel verarbeitet ein Agent 188 Profile. Nach einem ersten Durchgang waren 160 erfolgreich, 28 fehlten. Ein Checkpoint speicherte die Resultate, sodass der erneute Lauf nur die verbleibenden 28 bearbeiten musste. Das ist eine nützliche Technik für produktive Agenten: Man bezahlt nicht für bereits abgeschlossene Arbeit, und ein Fehler muss nicht den gesamten Lauf zurücksetzen.
Gerade für AgentenCode lässt sich daraus ein allgemein gültiges Prinzip ableiten: Zwischenstände, Quellenversionen, Freigaben und bereits geprüfte Ergebnisse müssen außerhalb des Modells festgehalten werden. Das ist robuster und kostengünstiger als „noch einmal komplett recherchieren“.
Wo die neuen Stufen einsetzbar sind – und was offenbleibt
| Aufgabe | Startpunkt | Warum |
|---|---|---|
| Einzelne faktische Rückfrage | fast / niedrigere Stufe | Wenige Quellen und geringe Zusatzkosten |
| Regelmäßiger Hersteller- oder Versionscheck | medium | Kostenbewusst; Ergebnis nur bei echter Änderung vertiefen |
| Mehrstufige technische Recherche | high / xhigh | Umfangreiche Quellen, Tools und Verifikationsschritte |
| Kritische branchenübergreifende Due Diligence | Ultra-Pilot | Drei unabhängige Recherchen können blinde Flecken reduzieren |
| Rechtlich verbindliche Freigabe oder Sicherheitsentscheidung | Kein autonomes Ja/Nein | Menschliche Prüfung und primäre Nachweise erforderlich |
Die Einordnung ist unsere redaktionelle Entscheidungsmatrix; keine vom Anbieter garantierte Verteilung. Die derzeitige Preis- und Datenverarbeitungsregelung muss für jeden Endpunkt, die eigene Region und den jeweiligen Vertrag geprüft werden. Die veröffentlichte WANDR-Kennzahl ersetzt keine SLA-Aussage und keine rechtliche Gewährleistung.
Was Betreiber jetzt konkret testen sollten
Für einen sauberen Pilot eignen sich 20 echte Aufgaben mit bekanntem Soll-Ergebnis, verteilt auf einfache Nachschlagefragen, mehrstufige Produktrecherche und komplexe Quellenvergleiche. Alle Stufen werden mit denselben Eingaben verglichen, einschließlich erlaubter Tools, Suchzugriffe und Quellenanforderungen. Pro Lauf sollten Antwortqualität, nachvollziehbare Primärquellen, Tool-Aufrufe, Kosten, Dauer und Abbruchgründe aufgezeichnet werden.
Entscheidend ist die Kosten-Nutzen-Kurve, nicht der beste Einzelwert. Beispielsweise kann eine hohe Qualitätssteigerung bei einer kritischen, seltenen Entscheidung die Mehrkosten rechtfertigen, während dieselbe Konfiguration für einen stündlichen Routinecheck völlig unwirtschaftlich wäre.
FAQ
Ist „ultra“ kostenlos oder pauschal 21,71 Dollar teuer? Nein. 21,71 US-Dollar ist der vom Hersteller gemeldete durchschnittliche Kostenwert je WANDR-Testaufgabe, kein allgemeiner Preis eines Produktabonnements.
Gilt die Verbesserung um fast 90 Prozent für jeden Agentenlauf? Nein. Der Hersteller nennt sie für die neue „medium“-Konfiguration in den beschriebenen Messungen. Reale Kosten hängen von Aufgabe und API-Nutzung ab.
Was ist der Unterschied zwischen xhigh und ultra? xhigh ist ein tieferer einzelner Agentenworkflow, während ultra drei voneinander unabhängige Recherchen parallel ausführt und sie mit einem vierten Agenten zusammenführt.
Warum braucht ein Agent sowohl Schritt- als auch Toollimits? Ein einzelner Modellschritt kann mehrere Toolaufrufe auslösen; nur die Schrittlänge zu begrenzen verhindert keine Kostenexplosion.
Kann sich die Qualität bei gleichem Effort-Namen ändern? Ja. Perplexity optimiert die Konfigurationen laufend; für reproduzierbare Systeme sollten Modell-/Effort-Versionen und Testbedingungen festgehalten werden.
Fazit: Der günstigste Agent ist nicht der schnellste und nicht der gründlichste
Perplexitys neue Agent-API-Stufen zeigen, wie viel Leistung in einer besseren Orchestrierung steckt. Budgetgrenzen, gezielte Datenextraktion, Checkpoints, Skills und passende Modelle können mehr bewirken als ein pauschaler Wechsel zum größten Modell.
Ultra ist ein ernstzunehmender Ansatz für schwierige Recherchen – aber keine vernünftige Standardkonfiguration für jede Frage. Der Burggraben produktiver KI-Agenten entsteht nicht durch möglichst viele parallele Modelle, sondern durch nachvollziehbare Ergebnisse pro eingesetztem Euro.
Quellen & Einordnung
Herstellerangaben und redaktionelle Bewertung, Stand 07.11.2026. Keine unabhängige Benchmarkwiederholung, keine eigene Produktionsinstallation und keine Sicherheitszertifizierung.