
Die beste Auswahl beginnt nicht mit einem Top-10-Ranking, sondern mit einer Aufgabe. Recherche, Programmierung und IT-Betrieb brauchen unterschiedliche Werkzeuge. Entscheidend sind der nachweisbare Endzustand und die erlaubten Handlungen – nicht die längste Funktionsliste.
Definiere zuerst die Aufgabe, dann die erforderlichen Rechte. Prüfe den Verfügbarkeitsstatus und die Quellen. Vergleiche zwei bis drei Kandidaten mit denselben Testfällen. Erlaube kritische Schreibaktionen erst nach dokumentierter Freigabe.
Welcher KI-Agent passt zu mir? Die direkte Antwort
Der passende KI-Agent ist derjenige, der eine konkrete Aufgabe mit belegbaren Ergebnissen und kontrollierbaren Rechten ausführen kann. Für Quellenrecherche kommen Recherche-Agenten, für Arbeit am Repository Coding-Agenten und für betriebliche Störungen spezialisierte SRE-Agenten in Betracht. Benötigst du nur einen Textentwurf, muss es kein handelnder Agent sein.
Formuliere zuerst das Ziel, dann die Daten und Werkzeuge, schließlich die Risiken. Erstelle aus zwei oder drei Kandidaten eine überprüfbare Vorauswahl. AgentenFit hilft beim Anforderungsabgleich, AgentenCheck bei der strukturierten Prüfung und AgentenVergleich bei den dokumentierten Unterschieden. Keines dieser Werkzeuge garantiert Eignung, Sicherheit oder Leistung.
1. Die richtige Frage lautet: Welche Aufgabe soll erledigt werden?
„Wir brauchen KI im Vertrieb“ ist keine brauchbare Anforderung. Besser: „Erstelle aus freigegebenen CRM-Feldern eine überprüfbare Angebotsvorlage, ändere aber keine Preise und verschicke nichts ohne menschliche Freigabe.“ Darin stecken die Aufgabe, zulässige Daten, der erwünschte Endzustand und verbotene Aktionen. Genau daraus entsteht später ein realistischer Test.
Notiere dazu Häufigkeit, Zeitaufwand, wichtige Ausnahmen und mögliche Fehlerfolgen. Manche Aufgaben sind selten und offen; andere laufen jeden Tag gleich. Der Prozess sollte den Agententyp bestimmen, nicht umgekehrt. Die Microsoft-Leitlinien zur Agenten-Adoption unterscheiden sinnvoll zwischen Planung, Governance, Implementierung und Betrieb.
2. Wann reicht ein Chatbot oder eine klassische Automation?
Ein Chatbot beantwortet Fragen und kann Entwürfe erstellen. Eine klassische Automation durchläuft fest definierte Regeln. Ein KI-Agent kann bei entsprechender Ausstattung mehrere Schritte planen, auf Zwischenergebnisse reagieren und Werkzeuge verwenden. Die Grenzen sind fließend; entscheidend ist nicht, was ein Anbieter sein Produkt nennt, sondern welche Aktionen es tatsächlich ausführen darf.
Für eine einfache Zusammenfassung genügt meist ein Assistent. Ein vollständig regelbasierter täglicher Export gehört eher in einen festen Workflow. Unvorhersehbare Recherche oder Diagnosen, bei denen immer neue Informationen überprüft werden müssen, können agentisches Handeln rechtfertigen. Mehr Autonomie ist nicht automatisch besser: Jeder zusätzliche Zugriff erfordert eine passende Verantwortlichkeit. Vertiefung: KI-Agent vs. Chatbot.
3. Welchen Agententyp brauche ich?
Recherche-Agenten sollen Suchschritte nachvollziehen, Originalquellen verlinken und Unsicherheit sichtbar machen. Coding-Agenten benötigen Repository-Zugriff, Tests und einen kontrollierten Änderungsprozess. SRE-Agenten brauchen Logs, Telemetrie, Incidents und Runbooks. Unternehmensagenten hängen vor allem von zugelassenen Datenquellen, CRM-/ERP-Rechten und Freigaben ab.
Zwei Produkte mit demselben Sprachmodell können sich gerade bei Tools, Kontextzugriff, Workflow und Rechtevergabe fundamental unterscheiden. Ein Produktvergleich sollte diese operativen Fähigkeiten abbilden. Für einen breiteren Überblick siehe Arten von KI-Agenten und KI-Agenten im Unternehmen.
4. Sechs echte Agentenprofile nach Aufgabenklasse
Unsere Tabelle ist eine redaktionelle Zuordnung von Aufgaben und dokumentierten Produktrollen, kein Benchmark und keine Rangliste. Verfügbarkeit und Nutzungsbedingungen können sich ändern. Die Links führen zu den quellenbasierten Profilen mit weiterführenden Hinweisen; ein fehlender Evidenzwert darf nicht stillschweigend positiv ausgelegt werden.
Bei einem einzelnen Ziel ist es meistens sinnvoller, zwei geeignete Kandidaten tief zu prüfen, als zwanzig Namen oberflächlich anzusehen. Wer Code bearbeitet, braucht einen anderen Prüfplan als ein Betriebsteam mit produktiven Schreibrechten. Die Auswahlmatrix unten macht diese Unterschiede sichtbar.
| Aufgabenklasse | Agentenprofil | Worauf achten? |
|---|---|---|
| Quellenbasierte Webrecherche | ChatGPT Deep Research | Quellen, Limits und Tarif prüfen |
| Repository-Code bearbeiten | OpenAI Codex | Datei- und Befehlsrechte begrenzen |
| Open-Source-Coding | OpenCode | Modellzugang und Infrastruktur prüfen |
| Incident-Triage und Runbooks | PagerDuty Paige | GA; Einzelfunktionen gesondert |
| Traces und Release-Checks | Honeycomb AI SRE Agents | Personal/Team: Early Access |
| Cloud-/Infrastrukturdiagnose | AWS DevOps Agent | Region und Integrationen prüfen |
5. Vier Stufen: lesen, vorschlagen, freigeben, autonom handeln
Unterscheide Leserechte zum Kontextaufbau, Vorschläge ohne Außenwirkung, genehmigte Ausführung und eng begrenzte autonome Aktionen. Ein Agent, der ein Ticket zusammenfasst, ist anders zu kontrollieren als einer, der eine Produktionskonfiguration ändert oder Kundendaten versendet. Der spätere Ausbauschritt ist keine Pflicht.
Prüfe jedes Tool und jede Identität: Was darf gelesen, geändert, gelöscht oder an externe Systeme übertragen werden? Welche Freigabe ist verbindlich, gibt es ein Protokoll und einen Not-Aus? Die OWASP Top 10 for Agentic Applications 2026 benennt Risiken wie Toolmissbrauch und Privilegienausweitung. Ein solches Framework ist jedoch keine Zertifizierung eines bestimmten Produkts. Mehr unter Human-in-the-loop.
6. Verfügbarkeit, Datenschutz und Integrationen getrennt überprüfen
Ein Agent kann allgemein verfügbar, Beta, Early Access oder regional eingeschränkt sein. Ein GA-Label für das Produkt deckt nicht automatisch alle Funktionen ab. PagerDuty Paige wurde am 3. November 2026 allgemein verfügbar angekündigt; einzelne Funktionen sind gesondert einzuordnen. Honeycomb Personal und Team Agents befanden sich zum Prüfdatum hingegen im Early Access.
Kontrolliere Anbieter, Tarif, verknüpfte Systeme, personenbezogene Daten, Speicher- und Verarbeitungsregionen, Aufbewahrungsfristen sowie die tatsächliche Ausführungsidentität. Ohne produktspezifischen Vertrag oder technische Dokumentation bleibt ein Feld unbekannt. NISTs AI Risk Management Framework: Generative AI Profile bietet eine freiwillige Orientierung für Risikomanagement, keine automatische Produktfreigabe.
7. Kosten je richtig erledigter Aufgabe statt Preis pro Antwort
Ein billiges Abo kann teuer werden, wenn viele Versuche scheitern oder Mitarbeitende die Ergebnisse vollständig nacharbeiten müssen. Kalkuliere Lizenzen, Modell- und Toolverbrauch, Einrichtung, Datenschutz, Freigaben, Monitoring und Fehlkosten getrennt. Nutzungsabhängige AI Actions oder API-Preise müssen vor dem Kauf für den tatsächlichen Umfang geprüft werden.
AgentenCode empfiehlt, die Vollkosten pro überprüft akzeptiertem Ergebnis zu vergleichen. Dazu brauchst du eigene Testdaten – nicht nur Herstellerpreise und versprochene Zeitgewinne. Unser Kosten- und ROI-Leitfaden enthält die dazugehörige Methodik mit ausdrücklich hypothetischen Beispielen.
8. Wie vergleiche ich KI-Agenten fair?
Nutze für alle Kandidaten dieselben realistischen Aufgaben, zulässigen Quellen und Erfolgskriterien. Dokumentiere neben dem Endergebnis die verwendeten Tools, belegten Aussagen, Fehlversuche, nicht genehmigten Aktionen, Wiederholungen und den Aufwand für menschliche Kontrolle. Ein einziger guter Durchlauf oder eine überzeugende Demo ist noch kein Qualitätsnachweis.
Die Anthropic-Anleitung zu Agent-Evals und die OpenAI-Dokumentation erläutern Testfälle und Grader. Für einen ersten Lernpilot können 20 bis 50 gut beschriebene Fälle hilfreich sein; sie beweisen jedoch keine geringe Fehlerquote bei seltenen schweren Schäden. Unsere Eval-Referenz vertieft die Details.
9. Die eigene AgentenCode-Auswahlmatrix ohne Scheingenauigkeit
Treffe die Entscheidung in zwei Durchgängen. Zuerst gelten harte Ausschlussregeln: falsche Aufgabenklasse, nicht verfügbarer Zugang, nicht zulässige Datenverarbeitung, unkontrollierbare Schreibrechte oder fehlender Testmodus. Kein noch so hoher Werbe-Score kann einen kritischen Verstoß gegen diese Grenzen ausgleichen.
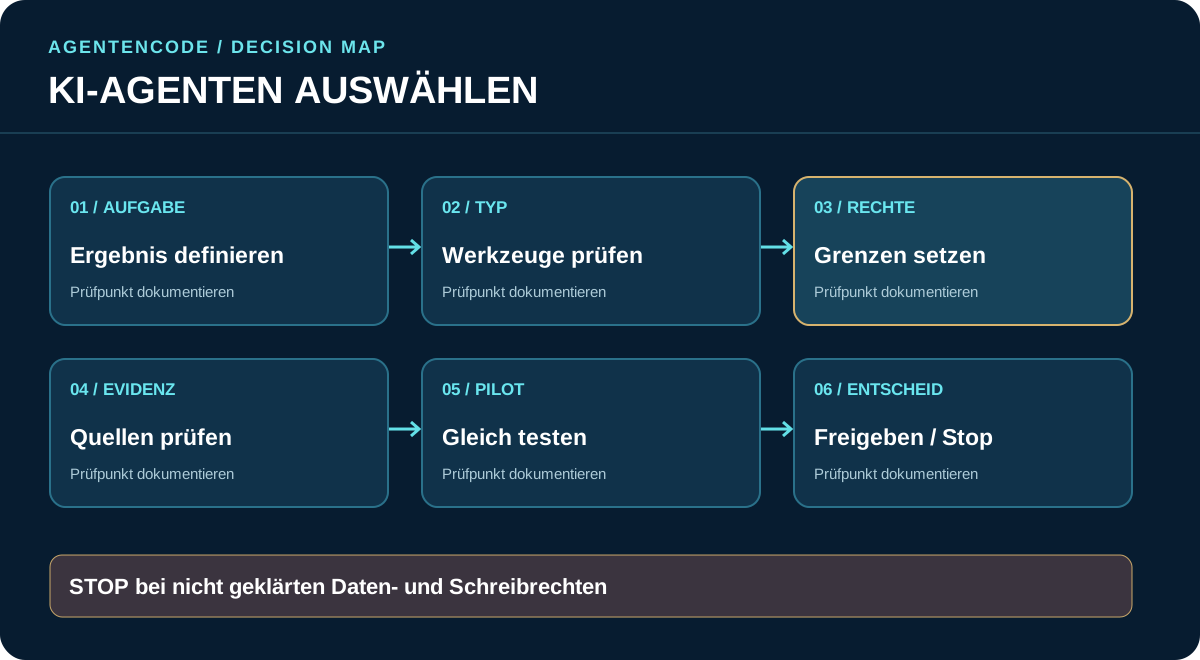
Erst danach bewertest du die übrigen Kandidaten qualitativ nach Aufgabenpassung, überprüfbarer Evidenz, Integration, Bedienaufwand und Vollkosten. Kennzeichne fehlende Informationen als „unbekannt“, nicht als Null oder geschätzten Prozentwert. Unsere eigene Entscheidungsillustration zeigt die sechs Schritte. Sie ist ein methodischer Vorschlag und kein gemessener Produkttest.
10. Praxisbeispiel: Wettbewerbsrecherche als risikoarmer Einstieg
Angenommen, ein kleines Team erstellt freitags einen Bericht aus öffentlich zugänglichen Wettbewerbsankündigungen. Ein Recherche-Agent darf definierte Webseiten analysieren und einen Entwurf mit überprüfbaren Zitaten erzeugen. Er darf keine privaten CRM-Daten abrufen und keinen Bericht ohne Prüfung verschicken. Zwei Kandidaten erhalten dieselben Fragestellungen; Menschen vergleichen Aussagen und Quellen.
Dafür könnten ChatGPT Deep Research und Gemini Deep Research als Ausgangspunkt dienen. Dieses Szenario ist hypothetisch; AgentenCode hat weder eine solche Kundenaufgabe durchgeführt noch die Produkte hier gegeneinander gemessen. Die Unterscheidung zwischen dokumentierter Funktion und real gemessener Güte ist entscheidend.
11. Praxisbeispiel: Incident-Automation oder Trace-Überwachung?
Ein Bereitschaftsteam möchte Störungen einordnen und freigegebene Runbooks ausführen: PagerDuty Paige ist ein sinnvoller Prüfkandidat. Ein anderes Team überwacht Releases anhand vorhandener Traces und SLOs: Dann ist Honeycomb AI SRE Agents eine relevante, noch Early-Access-beschränkte Alternative. Für AWS- und Infrastrukturdiagnosen lohnt sich außerdem ein Blick auf AWS DevOps Agent.
Das sind verschiedene Einsatzschwerpunkte, keine Aussage über einen Testsieger. Beim ersten Fall sind Runbook-Rechte und Rollback besonders wichtig, beim zweiten die Trace-Vollständigkeit und die Belege für Regressionen. Beide brauchen klare Eskalationen. Eine Herstellerbeschreibung kann den eigenen Sicherheits- und Funktionstest nicht ersetzen.
12. In 14 Tagen zur begründeten Vorauswahl
Tag 1–2: Aufgabe, gewünschtes Ergebnis und Ausschlusskriterien dokumentieren. Tag 3–4: zwei oder drei Kandidaten anhand offizieller Quellen und Zugangsbedingungen prüfen. Tag 5–9: identische risikoarme Testfälle ausführen. Tag 10–12: Qualität, Rechte und Vollkosten auswerten. Tag 13–14: dokumentiert stoppen, nachbessern oder einen begrenzten Folgepilot freigeben.
Der 14-Tage-Plan ist unser redaktioneller Vorschlag und kein allgemeiner Marktstandard. Bei sensiblen oder hochkritischen Prozessen müssen rechtliche, fachliche und technische Prüfungen weiter reichen. Entscheidend sind reproduzierbare Ergebnisse und nachvollziehbare Grenzen – nicht die Zeit bis zur ersten Antwort.
13. AgentenFit, AgentenCheck und AgentenVergleich sinnvoll kombinieren
Starte mit AgentenFit, um deine Aufgabe auf dokumentierte Merkmale abzubilden. Prüfe anschließend aktuelle Herstellerquellen und Verträge; mit AgentenVergleich kannst du zwei Kandidaten nebeneinander ansehen. Vor produktiven Datenzugriffen und Aktionen ergänzt AgentenCheck die wichtigsten Risiko- und Evidenzfragen.
AgentenCode ist eine unabhängige quellenbasierte Referenz und keine Behörde, Zertifizierungsstelle oder Live-Benchmark-Datenbank. Ein dokumentiertes Trust-Merkmal ist keine selbst ausgeführte Sicherheitsprüfung. Deshalb geben unsere Tools Hinweise für eine Auswahl, aber keine Garantie für ein bestimmtes Produkt.
Fazit: Der beste Agent ist der kleinste, der dein Ziel sicher erreicht
Bevorzuge nicht automatisch die größte Funktionsliste oder die stärkste Autonomie. Der richtige Agent erfüllt eine klar beschriebene Aufgabe überprüfbar, zu vertretbaren Vollkosten und mit begrenzten Berechtigungen. Wenn ein Assistent oder eine feste Automation ausreicht, ist weniger Komplexität oft die bessere Entscheidung.
Für den Einstieg genügen zwei passende Kandidaten und ein enger, dokumentierter Einsatzfall. Suche im Agentenverzeichnis nach Aufgabenklassen oder beginne direkt mit AgentenFit.
Häufige Fragen
Welcher KI-Agent ist 2026 der beste?
Einen allgemein besten KI-Agenten gibt es nicht. Aufgabenpassung, Datenzugriff, Berechtigungen, Verfügbarkeit und eigene Tests entscheiden.
Welcher KI-Agent eignet sich für Anfänger?
Beginne mit einem Assistenten mit wenig Rechten. Ein handelnder Agent lohnt sich erst, wenn die Aufgabe mehrstufige Toolnutzung benötigt.
Muss ich programmieren können?
Nicht immer. Einige Agenten bieten fertige Oberflächen. Bei geschäftlichen Integrationen bleiben Rechte- und Datenschutzprüfungen wichtig.
Ist ein Early-Access-Agent schlechter als ein GA-Agent?
Nicht zwangsläufig. Early Access beschreibt zunächst den Zugangsstatus, nicht die gemessene Qualität. Funktionen müssen separat geprüft werden.
Findet AgentenFit den sicher besten Agenten?
Nein. AgentenFit strukturiert einen Abgleich dokumentierter Merkmale, ersetzt aber weder eigene Tests noch Vertrags- und Sicherheitsprüfungen.
Wie viele Agenten sollte ich vergleichen?
Für eine konkrete Aufgabe reichen zu Beginn oft zwei bis drei Kandidaten. Höhere Risiken erfordern zusätzliche Fachprüfungen und Tests.
Primärquellen, Methodik und Grenzen
Dieser Leitfaden verbindet eine eigene redaktionelle Auswahlmethodik mit öffentlich dokumentierten Standards, Herstellerunterlagen und den AgentenCode-Profilen. Das ist kein eigenständig ausgeführter Produkt-Benchmark, keine Datenschutzprüfung und keine Zertifizierung. Produktdetails, Verfügbarkeit und Preise müssen anhand aktueller Primärquellen geprüft werden.
- Microsoft: AI agent adoption
- Microsoft: Agent adoption maturity model
- NIST: AI RMF Generative AI Profile
- OWASP Top 10 for Agentic Applications 2026
- Anthropic: Demystifying Evals for AI Agents
- OpenAI: Agent Evals
Redaktioneller Stand: 2026-11-04. Unsere Methodik · KI-Agenten testen · Kosten & ROI.