
AgentenCode Aktuelles · 18. Oktober 2026 · Arbeitswelt · KI-Agenten und Governance
Anthropic-Studie: KI-Agenten verändern Arbeit und Personalplanung
Anthropic untersucht den Einsatz von KI-Agenten, menschliche Kontrolle und Junior-Einstellungen. Fakten, Grenzen und Einordnung der neuen Studie.
Direktantwort
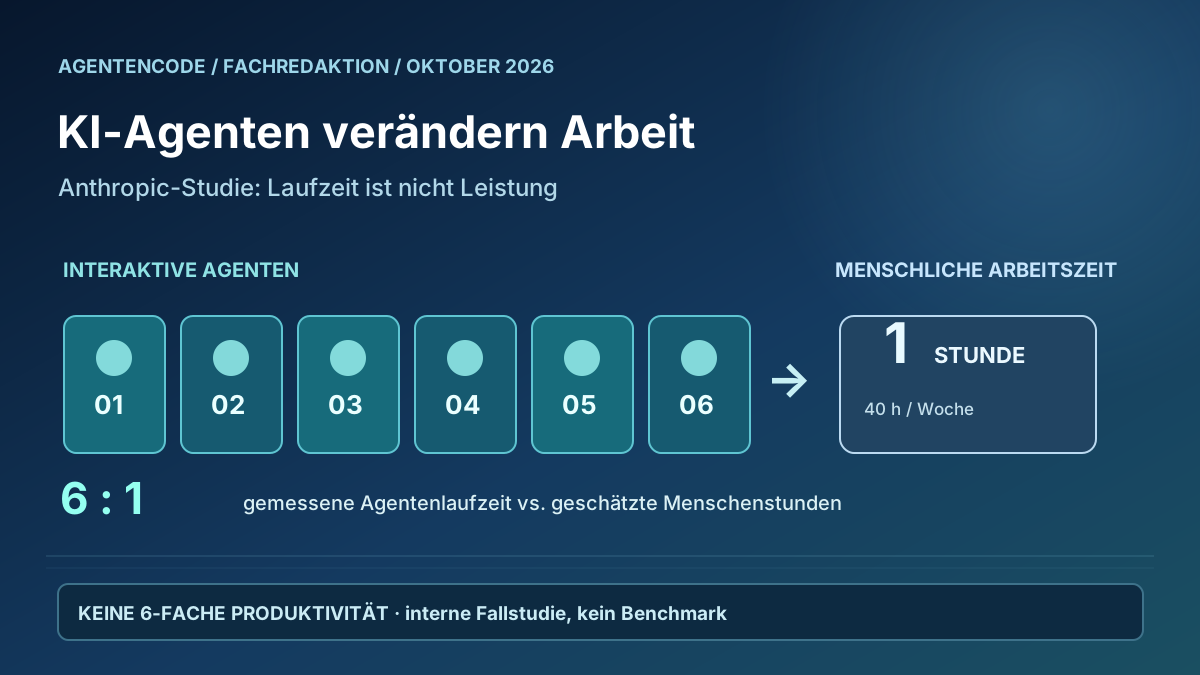
Die am 16. Oktober 2026 veröffentlichte Anthropic-Studie beschreibt, wie KI-Agenten die Arbeit im eigenen Unternehmen verändern. Im August erreichte die interaktive Agentenlaufzeit das Sechsfache der angenommenen Arbeitsstunden ihrer menschlichen Nutzer. Das ist keine sechsfache Produktivität und keine repräsentative Zahl für die gesamte Wirtschaft.
Was Anthropic untersucht hat
Das Anthropic Institute veröffentlicht am 16. Oktober 2026 den Forschungsbericht „How employment is changing at Anthropic“ von Nathan Wilmers, Regina Catipon, Maxim Massenkoff und Peter McCrory. Grundlage sind interne Nutzungs- und Personaldaten, Produktivitätsindikatoren, Kalenderinformationen, Mitarbeiterbefragungen, Kommunikationsmuster und 17 Interviews. Anthropic analysiert damit eine Organisation, die eigene KI-Agenten besonders intensiv nutzt. Diese interne Fallstudie zeigt mögliche Entwicklungen auf, ist aber keine unabhängige repräsentative Untersuchung deutscher Unternehmen.
Die gemeldete Kennzahl 6:1 vergleicht die Laufzeit von durch Beschäftigte eingesetzten interaktiven Agenten mit rechnerisch angenommenen menschlichen Stunden. Die Menschenbasis liegt bei 40 Stunden pro Woche; für Agenten erfasst die Studie aktive Modellberechnung und Werkzeugausführung, jedoch nicht längere Wartezeiten über 30 Minuten. Es handelt sich daher weder um eine exakte Messung menschlicher Arbeitszeit noch um eine Aussage über tatsächlichen wirtschaftlichen Nutzen.
Mehr Code pro Person – aber wie belastbar ist der Effekt?
Anthropic beschreibt wachsende Code-Commits pro Entwickler sowie Veränderungen im Vertrieb und in der Vertragsbearbeitung. Für einen Vergleich der Einführung von Coding-Agenten beobachteten die Forschenden unter anderem 192 Entwickler, die solche Werkzeuge übernahmen, und 74 Nichtanwender während der betrachteten Monate. Bei einigen Indikatoren für Codequalität – etwa später entfernte oder revertierte Zeilen – fanden sie unter vergleichbaren Bedingungen keinen Unterschied zwischen menschlich und agentisch erstelltem Code.
Das ist interessant, beweist aber nicht generell fehlerfreien Agentencode. Auch die Studienautoren betonen, dass spätere Anwender bereits vor der Einführung einen steileren Output-Trend hatten. Die Auswahl des Werkzeugs erfolgte nicht zufällig; zugleich wuchs das gesamte Unternehmen stark. Eine eindeutige kausale Zuordnung sämtlicher Produktivitätsfortschritte zu Claude wäre deshalb unzulässig. Andere Teams sollten Kosten, Korrekturen, Fehler und tatsächlichen Nutzen selbst messen.
Menschliche Aufmerksamkeit wird zum Engpass
Besonders deutlich zeigt sich die organisatorische Seite: Nach der Studie verbringen interaktive Claude-Sessions etwa 80 Prozent ihrer verstrichenen Zeit mit Warten auf menschlichen Input. Für Beschäftigte ohne technische Rollen könnte das Lesen aller erzeugten Antworten nach einer Modellrechnung mehr als eine halbe Arbeitswoche beanspruchen. Die Autoren leiten das aus Ausgabe-Token, Wortannahmen und einer durchschnittlichen Lesegeschwindigkeit ab; es ist keine tatsächlich gemessene individuelle Lesezeit.
Beschäftigte reagieren laut Bericht, indem sie neue Werkzeuge entwickeln: Dashboards, Agenten-Monitoring, Anweisungssammlungen und Prüfketten für fremde Agentenergebnisse. Der Anteil solcher Meta-Aufgaben wächst. Die Agenten beseitigen also nicht die Notwendigkeit von Management, sondern verschieben einen Teil der Arbeit auf Spezifikation, Freigaben, Koordination und das Sichtbarmachen von Entscheidungen.
Junior-Einstellungen: eine wichtige, aber begrenzte Beobachtung
Anthropic meldet einen rückläufigen Anteil von Mitarbeitenden auf frühen technischen Karrierestufen. Innerhalb der betrachteten technischen Abteilungen fiel der Anteil der Junior-Beschäftigten von 21 auf 14 Prozent. Noch deutlicher veränderte sich ihr Anteil an technischen Neueinstellungen: von 27 auf 9 Prozent. Gleichzeitig stellte Anthropic insgesamt weiterhin ein und expandierte. Diese Angaben bedeuten weder einen belegten flächendeckenden Stellenabbau noch eine Prognose für den deutschen Arbeitsmarkt.
Für Führungskräfte entsteht daraus dennoch eine echte Frage: Wie sollen Berufseinsteiger künftig praktische Fähigkeiten aufbauen, wenn immer mehr einfache Aufgaben von Agenten vorbereitet werden? Die Forschenden diskutieren interne Versetzungen und veränderte Rollen, liefern dafür aber keine allgemein erprobte Lösung.
Konsequenzen für Unternehmen und AgentenCode
Ein Pilot mit KI-Agenten sollte nicht bei der Anzahl automatisch abgeschlossener Teilschritte enden. Ebenso wichtig sind Aufsichtsstunden, Korrekturen, Fehlerhäufigkeit, Eskalationen und der Aufwand bis zur menschlichen Abnahme. Für sensible Aktionen braucht es vorab definierte Freigaben. Ein Team, das nur die Geschwindigkeit der ersten Agentenantwort misst, kann durch Nacharbeit später sogar Zeit verlieren. Das ist eine organisatorische Schlussfolgerung, nicht der empirische Nachweis für ein bestimmtes Produkt.
Unser Profil von Claude Code liefert einen konkreten Bezug zu Anthropic-Agenten; die interne Studie bescheinigt jedoch nicht automatisch eine bestimmte Leistung oder Verfügbarkeit des öffentlichen Produkts. Im Fachartikel Agentic Organizations ordnen wir die Zusammenarbeit von Menschen und Agenten strukturell ein. AgentenFreigabe bietet ergänzende Kriterien für kontrollierte Abläufe.
AgentenCode · eigene Meinung
Meine Einordnung: Was diese Studie für Unternehmen bedeutet
Meine Einschätzung: Das Verhältnis 6:1 ist als Schlagzeile verführerisch, aber die entscheidende Zahl ist für mich der zusätzliche Prüf- und Koordinationsaufwand. Eine Organisation mit vielen Agenten muss lernen, deren Ergebnisse nachvollziehbar zu kontrollieren. Ich würde von Beginn an menschliche Aufmerksamkeit und Nacharbeit als echte Kosten eines Piloten erfassen. Noch wichtiger finde ich, Berufsanfängern bewusst Gelegenheit zum Lernen zu geben. Wenn die einfachen Einstiegstätigkeiten entfallen, müssen andere Wege zu belastbarer Erfahrung entstehen. Das ist meine redaktionelle Position, keine eigene Untersuchung der Anthropic-Belegschaft.
Persönliche redaktionelle Einschätzung von Kai Schiller, keine eigene wissenschaftliche Messung.
Vier Fragen für die Praxis
- Agentenlaufzeit nie mit tatsächlicher Produktivität gleichsetzen
- Reviewaufwand, Fehler und Abnahmezeit im Pilot messen
- Qualifizierung und Perspektiven für Berufseinsteiger einplanen
- Produktmerkmale aus konkreten Primärquellen gesondert prüfen
Die Herstellerzahlen beziehen sich nicht automatisch auf einen bestimmten AgentenCode-Produkttarif. Funktionen, Rechte und tatsächliche Resultate müssen gesondert belegt werden.
Häufige Fragen
Bedeuten sechs Agentenstunden pro Menschenstunde sechsfache Produktivität?
Nein. Verglichen wird aktive Agentenlaufzeit mit einer unterstellten menschlichen Wochenarbeitszeit, nicht geschaffener Unternehmenswert.
Belegt die Studie Entlassungen aufgrund von Claude?
Nein. Sie dokumentiert eine veränderte Zusammensetzung technischer Junior-Einstellungen bei einem insgesamt wachsenden Unternehmen.
Lassen sich die Ergebnisse auf mittelständische Betriebe übertragen?
Nicht ohne Weiteres. Es handelt sich um eine interne Fallstudie eines KI-Unternehmens; eigene kontrollierte Prozesse und Kennzahlen sind nötig.
Offizielle Quellen und methodische Grenzen
Die Hauptmeldung wurde anhand des Forschungsberichts des Anbieters geprüft. Es handelt sich um interne Forschungs- und Nutzungsdaten, nicht um unabhängig reproduzierte Benchmarkzahlen oder einen Nachweis für jeden AgentenCode-Profilumfang.
- Anthropic Institute – How employment is changing at Anthropic ↗ · 16. Oktober 2026
- Anthropic – Agentic coding and persistent returns to expertise ↗ · zusätzlicher Kontext
Agentenprofil / Kontext
Claude Code – passendes Agentenprofil, Quelle und Tarif separat prüfen →
Coding-Agenten als Kategorie betrachten →
Agentic Organizations – Organisation und Verantwortung →
AgentenFit: Anforderungen prüfen →
Autor und Transparenz
Persönlicher Fachkommentar von Kai Schiller. Seine Einschätzung ist als redaktionelle Meinung gekennzeichnet. Wissenschaftliche Aussagen folgen den verlinkten Primärquellen; AgentenCode hat hierfür keine eigenen Produkttests durchgeführt.