
Codex entwirft Hardware: Warum ein KI-Prototyp noch keine serienreife Maschine ist
OpenAI berichtet von einem in weniger als einer Woche entwickelten Testgerät mit KI-entworfenem Gehäuse, Platine und Firmware. Doch Toleranzen und Montage machten weitere Prüfungen nötig. Was das für echte Engineering-Agenten bedeutet.
Am 3. November 2026 berichtet OpenAI über die Arbeit mit ChatGPT, Codex und GPT-6 Astra in der mechanischen und elektrischen Konstruktion. Zwei Mitarbeitende entwarfen mithilfe des Modells in weniger als einer Woche neben ihrer regulären Arbeit ein Testgerät, mit dem man mit Codex sprechen kann. Ein Auftragsfertiger fertigte laut OpenAI innerhalb eines Monats eine kleine Prototypenserie.
Quellenlage und Grenzen
- Primärquelle
https://openai.com/index/accelerating-engineering-for-the-physical-world/
- Einordnung, kein Produkttest
Hersteller- und Primärquellen vom 3. November 2026. Die Auswertung und Entscheidungsmatrix stammen von AgentenCode; keine eigenen Hardware-, Agentenlaufzeit- oder Sicherheitstests.
Das Wichtigste: Der Durchbruch liegt zwischen CAD und Fabrik
Am 3. November 2026 berichtet OpenAI über die Arbeit mit ChatGPT, Codex und GPT-6 Astra in der mechanischen und elektrischen Konstruktion. Zwei Mitarbeitende entwarfen mithilfe des Modells in weniger als einer Woche neben ihrer regulären Arbeit ein Testgerät, mit dem man mit Codex sprechen kann. Ein Auftragsfertiger fertigte laut OpenAI innerhalb eines Monats eine kleine Prototypenserie.
Die entscheidende Einschränkung steht in derselben Originalquelle: Bei Fertigungsgrenzen, mechanischen Toleranzen und Montagevorgaben arbeitete Astra nicht durchgehend zuverlässig. Deshalb waren mehrere menschliche Prüf- und Überarbeitungsrunden notwendig. Das ist ein Labor- und Entwicklungsbeispiel, keine frei verfügbare Funktion zum autonomen Bau beliebiger Produkte.
Was der Agent im Versuch tatsächlich übernahm
OpenAI beschreibt vier eng verzahnte Aufgaben: Anforderungen und Erscheinungsbild festlegen, Gehäuse und Innenaufbau konstruieren, elektronische Komponenten und Leiterplattenlayout erstellen sowie Benutzerschnittstelle, Firmware und Codex-Anbindung ausarbeiten. Bemerkenswert ist nicht eine einzelne erzeugte Zeichnung, sondern der Übergang zwischen Mechanik, Elektronik und Software.
In der Unternehmenspraxis arbeiten diese Disziplinen oft mit unterschiedlichen Dateiformaten, Werkzeugen und Zulassungsprozessen. Eine sprachbasierte Steuerung, die sie miteinander verbindet, könnte den Aufwand für Varianten und Rückfragen senken. „Könnte“ ist die redaktionelle Schlussfolgerung: OpenAI liefert noch keinen unabhängig reproduzierten Vergleich mit einem typischen Entwicklungsteam.
Wie weit die Ingenieurpraxis bereits reicht
OpenAI nennt eigene Hardware- und Infrastrukturteams, die CAD-Modelle, Fertigungszeichnungen, Simulationen und Designprüfungen mit Codex und ChatGPT vorbereiten. Seit Februar sei die modellbezogene Nutzung dieser Teams in Tokens um den Faktor 23 gestiegen. Das misst interne Nutzung, nicht einen um den Faktor 23 höheren Ingenieurdurchsatz.
Zwei weitere Projekte sind spannend, aber ihrem Status nach Forschungsarbeit: Mit Chip Ganassi Racing untersucht OpenAI die Umwandlung vorhandener 3D-Scans in bearbeitbare CAD-Modelle und zweidimensionale Fertigungszeichnungen. Die Ingenieure des Rennteams prüfen Geometrie und Produzierbarkeit. Mit Mazda erforscht OpenAI Strömungs- und Struktursimulationen für Fahrzeugkonzepte, einschließlich des Zielkonflikts zwischen Aerodynamik, Design und Kosten. Das ist keine Mitteilung über serienreife, von KI freigegebene Autos.
Der Benchmark ist interessant – aber nicht die ganze Antwort
In demselben Beitrag nennt OpenAI für BenchCAD 2.0 einen durchschnittlichen Wert von 0,875 für ein neueres internes Modell und 0,594 für GPT-6 Astra bei maximaler Denkleistung. Die Aufgaben betreffen unter anderem die Rekonstruktion von 3D-Teilen und den Zusammenhang zwischen Leiterplattenkomponenten.
Wichtig sind zwei Grenzen: Das besser bewertete Modell ist nicht als allgemein verfügbares Produkt ausgewiesen; und ein Benchmark-Score zu Modellierungsaufgaben belegt keine verlässlich beherrschte Fertigung, Materialprüfung, Produkthaftung oder Zulassung. Der Benchmarkanbieter beschreibt seinerseits weiterhin schwierige Montageaufgaben. BenchCADs Methodik ist ein hilfreicher Gegencheck zur Produktankündigung.
AgentenCode-Analyse: Wo der Entwicklungsagent stoppen muss
Die relevante Trennlinie ist nicht „KI oder Mensch“, sondern welcher Status aus einer KI-Ausgabe folgen darf. Unsere fünf Prüfgates lauten:
| Gate | Nachweisfrage | Status in der OpenAI-Mitteilung | Wer entscheidet? |
|---|---|---|---|
| 1. Entwurfsartefakt | Sind CAD, PCB und Firmware reproduzierbar vorhanden? | An einem Testgerät berichtet | Engineering-Team |
| 2. Geometrie und Funktion | Sind Passungen, Verbindungen und Simulationsergebnisse plausibel? | Teilweise über Tests und BenchCAD beschrieben | Fachprüfer |
| 3. Fertigbarkeit | Sind Toleranzen, Montage und Fertigungsgrenzen erfüllt? | Laut OpenAI noch unzuverlässig | Hersteller/Produktion |
| 4. Reale Validierung | Bestehen Prototypen ihre Prüfungen? | Kleinstserie berichtet, keine universellen Kennzahlen | Prüf- und Qualitätsteam |
| 5. Freigabe | Darf das Produkt hergestellt und eingesetzt werden? | Keine allgemeine Autonomie behauptet | Verantwortliche Organisation |
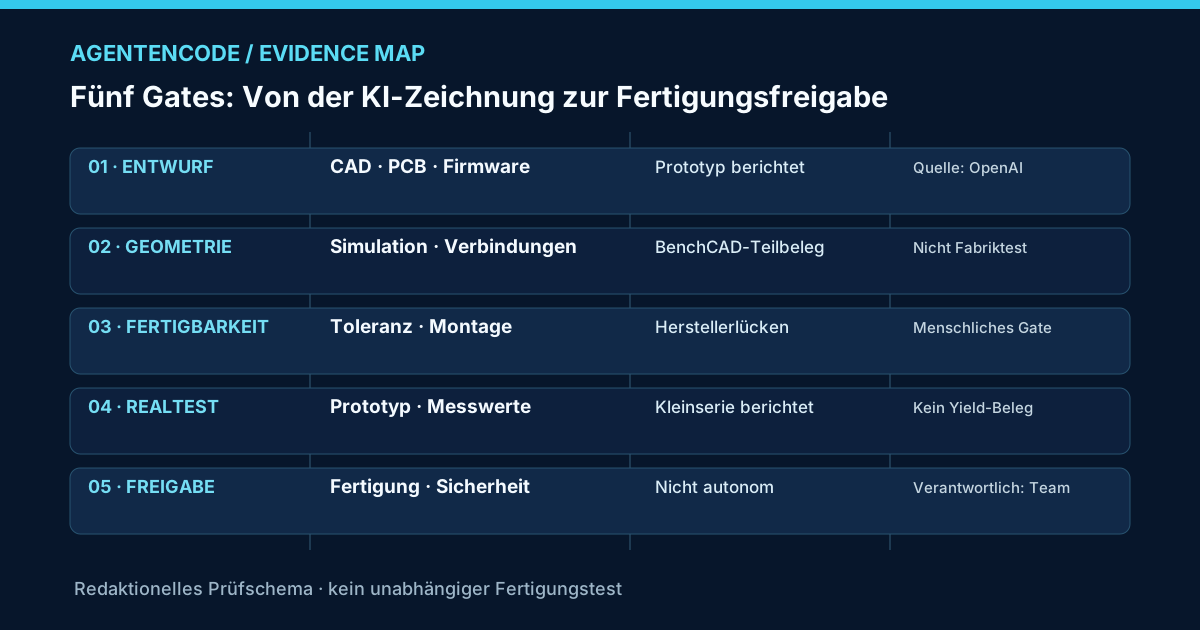
Die Matrix ist eine redaktionelle Einordnung der veröffentlichten Fakten, kein vom Hersteller zugesicherter Standard und kein eigener Labortest.
Die praktische Entscheidung für Unternehmen
Ein vernünftiger erster Pilot beginnt nicht mit einer sicherheitskritischen, direkt produzierten Baugruppe. Er kann bei CAD-Varianten, Stücklisten, Scan-zu-Modell-Konvertierung oder dem Übertragen von Konstruktionsergebnissen in Prüfprotokolle ansetzen. Wichtig sind Versionskontrolle, getrennte Schreibrechte, dokumentierte Material- und Toleranzannahmen, Simulation gegen Referenzfälle und eine verbindliche Fachfreigabe vor der Fertigung.
Der interessante Burggraben für Agenten liegt im überprüfbaren Übergang zwischen Werkzeugen. Wer nur einen CAD-Screenshot erzeugt, hat noch keinen Engineering-Workflow automatisiert. Wer dagegen Artefakte, Ausführungsschritte, Prüfergebnisse und Korrekturen reproduzierbar verbindet, löst einen erheblich schwierigeren Teil des Problems.
Fazit: Ein Vorbote, kein autonomes Werk
Die OpenAI-Ergebnisse zeigen, dass Modelle bereits mehrere Engineering-Disziplinen koordinieren können. Gerade das von OpenAI selbst benannte Scheitern an Fertigungsdetails ist entscheidungsrelevant: Eine gute CAD-Ausgabe ersetzt keine Toleranz-, Montage- und Sicherheitsfreigabe.
Drei häufige Fragen
Hat Astra das Gerät allein gebaut? Nein. Laut OpenAI wurden Entwürfe ohne direkte menschliche Änderungen erstellt; die tatsächliche Fertigung und die erforderlichen Überarbeitungen blieben menschlich beziehungsweise beim Auftragsfertiger.
Kann jedes Unternehmen das neue interne Modell nutzen? Das behauptet die Quelle nicht. Der höhere BenchCAD-Wert betrifft ausdrücklich ein neueres internes Modell.
Ist der Mazda-Einsatz bereits serienreif? Nein. OpenAI beschreibt eine Forschungskollaboration für Simulation und Design, keine genehmigte autonome Produktionskette.
Quellen, redaktionelle Methode und Grenzen
- OpenAI, „Accelerating engineering for the physical world“, 3. November 2026 — Primärquelle zum Testgerät, zu Nutzungsangaben, BenchCAD, Mazda und Chip Ganassi.
- BenchCAD, „Introducing BenchCAD 2.0“, 12. Oktober 2026 — ursprüngliche Benchmarkmethodik und beobachtete Fehler bei Assemblies.
Methode: Auswertung der datierten Hersteller- und Benchmarkquellen, redaktionelle Trennung von gemeldeter Leistung und betrieblicher Freigabe. Keine eigenen Modell-, Fahrzeug-, Hardware- oder Sicherheitsprüfungen. Die begleitende Illustration ist symbolisch und zeigt kein echtes Herstellerdesign. Weitere Entscheidungshilfen: KI-Agenten auswählen, AgentenCheck, AgentenVergleich.