
Googles KI-Agenten helfen bei mathematischen Beweisen: Was /teamwork wirklich zeigt
Google meldet Fortschritte mit kooperierenden KI-Agenten in Mathematik und Softwaretechnik. Was Lean verifiziert, welche Zahlen belegt sind und wo Grenzen bleiben.
Forschung statt gewöhnlicher Chatbot-Antworten
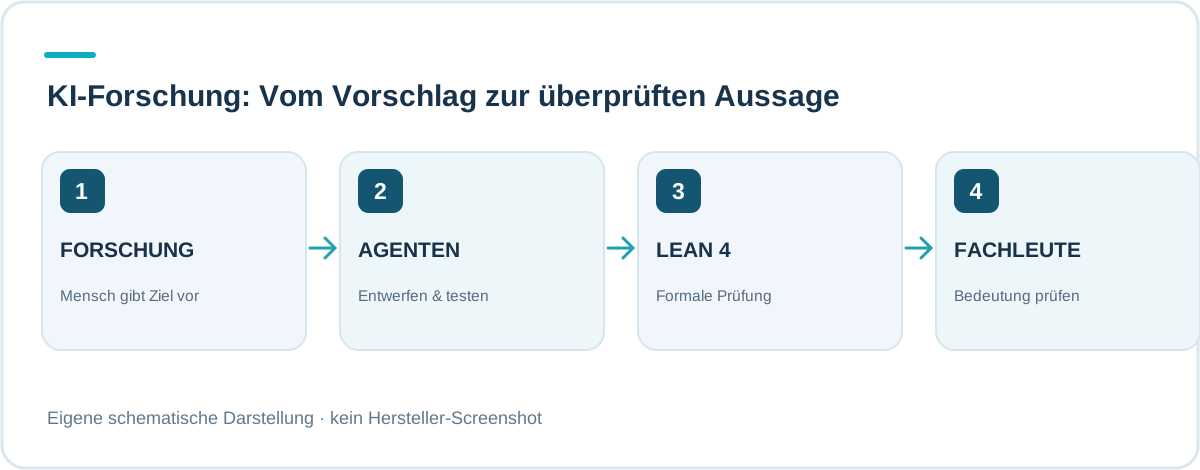
Am 13. November hat Google Research neue Ergebnisse der Antigravity-Funktion /teamwork vorgestellt. Mehrere spezialisierte Agenten lösen dabei nicht nur Textaufgaben: Sie durchsuchen Fachliteratur, schreiben Programme, testen Hypothesen und übergeben die Ergebnisse an gesonderte Prüfagenten. Menschen definieren das Problem und kontrollieren die fachliche Bedeutung.
Die Meldung ist ein Forschungs- und Produktbericht des Herstellers. Sie ist keine unabhängige Bestätigung, dass beliebige mathematische Fragen ohne menschliches Zutun gelöst werden können.
Wie /teamwork seine Arbeit aufteilt
Google beschreibt eine Koordination aus Planern, ausführenden Agenten, Kritikern und Prüfern. Einzelne Agenten erhalten gezielt nur die Dateien und Werkzeuge, die sie für ihren Teilschritt benötigen. Das soll Kontextverlust über lange Projekte verringern und gegenseitige Kontrolle ermöglichen.
Technische Überprüfungen reichen von unveränderten Softwaretests bis zu Lean 4: Der formale Beweisassistent lässt nur Schlussketten zu, die den definierten Regeln entsprechen. Eine erfolgreiche Lean-Prüfung bedeutet trotzdem nicht automatisch, dass die formal formulierte Aussage das ursprünglich gemeinte Forschungsproblem vollständig abbildet.
Die spektakulärste Kennzahl: 1,8 Millionen Zeilen Lean
Laut Google Research entstand für eine Formalisierung der Weil-Vermutungen ein rund 1,8 Millionen Zeilen umfassender Lean-Beweis in 28.800 Teilagenten-Aufrufen. Das Projekt bezieht sich auf historisch bereits bewiesene Mathematik; die Leistung ist die maschinelle Formalisierung, nicht ein neuer Beweis einer bislang offenen Weil-Vermutung.
Google berichtet zudem über mehr als 919.000 Lean-Zeilen für eine Formalisierung eines neueren Hilbert-Problems. Solche Größenangaben messen Umfang und Automatisierung, nicht automatisch Eleganz, mathematische Neuheit oder Akzeptanz durch unabhängige Fachgutachter.
Wo tatsächlich neue Resultate berichtet werden
Neben Formalisierungen nennt Google Kooperationen zu bislang offenen Fragen in Statistik, Optimierung und theoretischer Informatik – darunter adaptive Datenanalyse und dynamische Graphen. Die Arbeiten kombinieren KI-generierte Vorschläge mit menschlicher Forschungsarbeit und teilweise maschinengeprüften Resultaten.
Wer einen Durchbruch bewerten will, sollte deshalb drei Ebenen unterscheiden: eine Herstellerankündigung, einen nachvollziehbaren formal oder experimentell geprüften Befund und die unabhängige fachliche Begutachtung. Diese Ebenen dürfen nicht gleichgesetzt werden.
Warum das für alltägliche KI wichtig ist
Das Muster könnte über die Mathematik hinaus Bedeutung gewinnen: Ein Agent erzeugt einen Lösungsvorschlag, ein anderer sucht systematisch Gegenbeispiele und ein dritter bewertet nur messbare Resultate. Bei Softwareprojekten wäre das etwa eine Kombination aus Codegenerierung, Tests, Security-Review und menschlicher Freigabe.
Auch bei Multi-Agenten-Systemen sind getrennte Rollen nicht automatisch verlässlicher. Zusätzliche Agenten können Fehler weiterreichen oder Kosten erhöhen, wenn Prüfschritte schlecht definiert sind.
Der praktische Prüfmaßstab für Unternehmen
Für einen Pilotversuch reicht ein schweres Rätsel nicht aus. Sinnvoller sind kleine Aufgaben mit eindeutigen Akzeptanzkriterien, eingefrorenen Testdaten und nachvollziehbaren Logs. Man misst die Qualität des Endergebnisses, die tatsächlich benötigte Rechenzeit sowie Fehler und manuelle Korrekturen.
In kritischen Abläufen bleiben Berechtigungen und Sicherheit ebenso wichtig wie Intelligenz. Ein formal korrekter Beweis gibt keine Erlaubnis, vertrauliche Daten ungeprüft an externe Tools zu senden.
Verfügbarkeit: Werkzeug ist nicht gleich Forschungsreife
Google beschreibt /teamwork und /boost in Antigravity als extern nutzbar, weitere spezialisierte Workflows sollen folgen. Die dokumentierten Forschungsergebnisse stammen aus aufwendig betreuten Kampagnen; sie sind nicht zwangsläufig als Knopfdruckfunktion für alle Nutzer verfügbar.
Preise, Quoten, unterstützte Arbeitsabläufe und regionale Einschränkungen müssen im jeweils aktuellen Produktkonto geprüft werden. Aus einer Forschungsdemonstration lässt sich keine garantierte Erfolgsquote für Kundenprojekte ableiten.
AgentenCode-Einordnung: Die Prüfinfrastruktur ist die eigentliche Nachricht
Der langfristige Fortschritt liegt weniger im Versprechen autonomer Genialität als darin, dass Agenten kontrollierbare Zwischenergebnisse liefern und von unabhängigen Werkzeugen geprüft werden können. Das macht Ergebnisse nachvollziehbarer und eröffnet anspruchsvolle Arbeitsabläufe über klassisches Chatten hinaus.
Ob das wirtschaftlich sinnvoll wird, hängt von realen Erfolgsquoten, Laufzeiten, Kosten und menschlicher Nachprüfung ab. Die heutige Ankündigung ist ein starkes Forschungssignal, aber keine allgemeine Garantie verlässlicher KI-Forschung.
Häufige Fragen
Hat Google eine offene mathematische Vermutung vollständig autonom gelöst?
Google nennt sowohl neue Forschungsergebnisse als auch die Formalisierung bereits bekannter Beweise. Die einzelnen Resultate müssen getrennt bewertet und fachlich geprüft werden.
Was ist Lean 4?
Ein formaler Beweisassistent, der nach exakt definierten Regeln logische Schlussketten maschinell prüft. Die Aussage muss das gemeinte Problem korrekt formalisieren.
Kann jeder /teamwork verwenden?
Google beschreibt die Funktion in Antigravity als extern verfügbar, aber die gezeigten Spezialforschungsabläufe und Zugangsbedingungen unterscheiden sich.
Warum sind mehrere Agenten nicht automatisch besser?
Zusätzliche Rollen erzeugen nur dann Mehrwert, wenn überprüfbare Aufgaben, echte Gegenprüfungen, Kostenkontrolle und menschliche Verantwortung vorhanden sind.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- Google Research – Advancing science & engineering with Antigravity's /teamwork, 13 November 2026
- Google Antigravity – Teamwork research workflows and access
- Lean 4 – official open-source theorem prover
Stand: 14. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.