
IBM Granite LLMON: Zwei offene KI-Modelle sollen Prompt Injection besser abwehren
IBM veröffentlicht Granite-4.1-LLMON-Previews in 3B und 8B. Wie das Format Anweisungen von fremden Daten trennt – und warum es noch keine Sicherheitsgarantie ist.
Warum KI-Systeme Befehle in Dokumenten verwechseln
Ein KI-Assistent liest Dokumente, E-Mails oder Suchergebnisse, um eine berechtigte Aufgabe zu erledigen. Enthält eines dieser Dokumente eine versteckte Anweisung, kann das Modell die fremde Aussage fälschlich wie einen Auftrag behandeln. Dieses Problem heißt indirekte Prompt Injection – und wird bei Agenten mit Werkzeugzugriff besonders kritisch.
IBM hat am 12. November zwei experimentelle Granite-4.1-LLMON-Modelle veröffentlicht. Ihr Ansatz setzt nicht erst auf das nachträgliche Erkennen verdächtiger Wörter, sondern auf eine eigene Struktur für die gesamte Eingabe.
LLMON macht die Rolle jedes Textblocks sichtbar
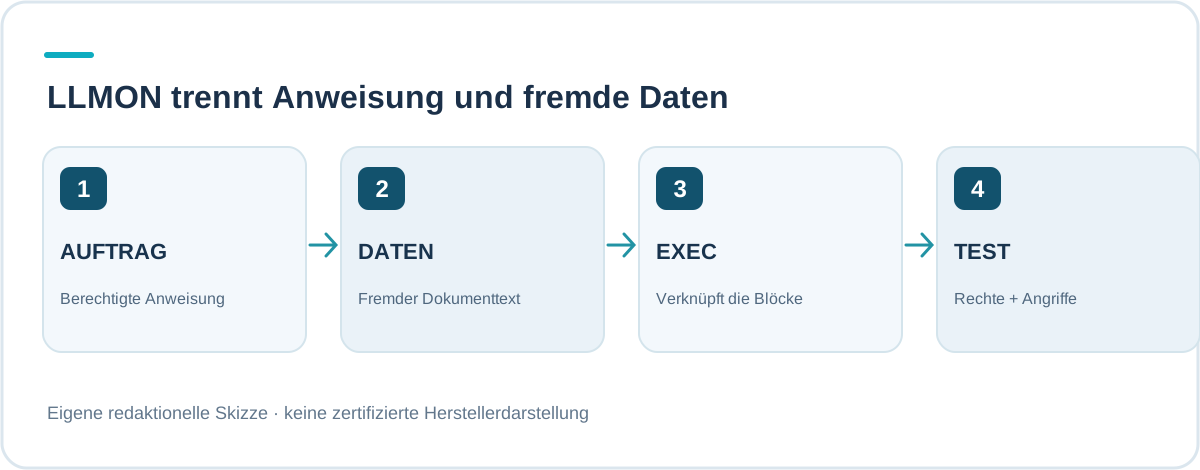
LLMON steht für LLM Object Notation. Das Format unterteilt Prompts in ausdrücklich bezeichnete Bereiche: etwa eine Anweisung, zu lesende Daten, Ausgabebedingungen und das angestrebte Ergebnis. Spezielle Token markieren diese Grenzen, statt dass das Modell gewöhnliche Satzzeichen interpretieren muss.
Ein zusätzliches `exec`-Element beschreibt, welche Anweisung auf welche Daten angewendet werden soll. So kann etwa ein Vertragsdokument als Datenquelle genutzt werden, ohne dass ein hineinkopierter Befehl plötzlich maßgeblich wird. Der Schutz hängt aber davon ab, dass die Anwendung Inhalte tatsächlich korrekt zuordnet.
Zwei offene experimentelle Modelle statt eines fertigen Standards
IBM stellt Previews auf Basis von Granite 4.1 in den Größen 3B und 8B auf Hugging Face bereit. Die 8B-Modellkarte nennt Apache 2.0 und zeigt die Nutzung des mitgelieferten Chat-Templates. Außerdem ist der LLMON-Werkzeugkasten öffentlich zugänglich.
Das erlaubt Forschungsgruppen und Entwicklungsteams, eigene Tests zu wiederholen. Die Previews sind ausdrücklich für Evaluation und Experimente gedacht, nicht als produktionsreifes Sicherheitsprodukt zertifiziert. Ein vorhandenes Repository ersetzt keine Sicherheitsprüfung der eigenen Anwendung.
Wie aussagekräftig sind die Prompt-Injection-Tests?
IBM berichtet auf Tests mit statischen indirekten Angriffsversuchen über deutliche Verbesserungen gegenüber gewöhnlichen Instruct-Modellen. In einzelnen Benchmarks fällt die Erfolgsrate eingeschleuster Befehle nach Herstellerangaben nahezu auf null. Die Versuche vergleichen konkrete Modelle und Prompt-Formate unter definierten Bedingungen.
Das Ergebnis ist bemerkenswert, aber nicht gleichbedeutend mit allgemeiner Immunität. Adaptive Angriffe über mehrere Nachrichten, fehlerhafte Tool-Berechtigungen oder eine Anwendung, die fremden Text irrtümlich als Anweisung markiert, sind damit nicht ausgeschlossen. Unabhängige reproduzierbare Tests bleiben notwendig.
Was Entwickler konkret untersuchen sollten
Ein sinnvoller Pilot lässt dieselben Dokumentaufgaben durch ein herkömmliches Granite-Instruct-Modell und durch das LLMON-Pendant laufen. Neben der korrekten Antwort sollte gemessen werden, wie häufig versteckte Befehle befolgt, harmlose Dokumentinhalte ignoriert oder unzulässige Werkzeugaktionen vorgeschlagen werden.
Besonders wichtig sind die Grenzen zwischen Suchtreffern, Werkzeugausgaben, Systemregeln und echten Nutzeraufträgen. LLMON kann eine Schutzschicht bilden, darf aber weder Dateirechte noch Netzwerksperren ersetzen. Unsere Sicherheitsgrundlagen erklären diese mehrschichtige Architektur.
AgentenCode-Einordnung: strukturelle Autorität statt Prompt-Zauber
Das Interessante ist nicht die XML-ähnliche Schreibweise, sondern die explizite Verbindung zwischen einer berechtigten Anweisung und genau den dazugehörigen Daten. Falls dieser Ansatz bei unabhängigen Tests überzeugt, könnte er die Entwicklung kleinerer, lokal ausführbarer Modelle widerstandsfähiger machen.
Vorerst handelt es sich um einen Forschungsstand mit offenen Gewichten. Wer die Methode produktiv einsetzen will, braucht zusätzliche Zugriffskontrollen, Monitoring und menschliche Freigaben bei riskanten Aktionen. Für systematische Nachweise und Sicherheitsgrenzen verweisen wir auf AgentenTrust.
Häufige Fragen
Sind die LLMON-Modelle frei erhältlich?
IBM veröffentlicht experimentelle Granite-4.1-Modelle in den Größen 3B und 8B samt Werkzeugen; die Modellkarte nennt Apache 2.0.
Verhindert LLMON jede Prompt Injection?
Nein. IBM berichtet Verbesserungen in bestimmten Benchmarks, aber keine universelle Garantie für adaptive oder anwendungsspezifische Angriffe.
Ist LLMON ein Ersatz für JSON?
Es ist ein für Sprachmodelle gestaltetes Strukturformat. IBM stellt Konverter für vorhandene JSON-Daten bereit, ohne bestehende Systeme grundsätzlich ersetzen zu müssen.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- IBM Granite – LLMON technical introduction, 12 November 2026
- IBM Granite 4.1 8B LLMON Preview – model card
- LLMON – original open-source toolkit
Stand: 14. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.