
llama.cpp 1.0 ist da: Warum lokale KI jetzt eine stabilere Grundlage bekommt
llama.cpp 1.0 und ggml 1.0 sind erschienen. Der Meilenstein ordnet API-Kompatibilität, Hardware-Unterstützung und den Einsatz privater KI neu ein.
Ein neuer Meilenstein für lokale KI
Das Team hinter llama.cpp hat am 13. November 2026 seine Bibliothek in Version 1.0.0 veröffentlicht. Parallel erreichte die zugrunde liegende Tensorbibliothek ggml ebenfalls Version 1.0.0. Seit Jahren ermöglicht das Projekt, große Sprachmodelle auf sehr unterschiedlichen Geräten auszuführen – vom privaten Laptop bis zu Servern.
Der Versionssprung betrifft in erster Linie das Softwarefundament. Er ist weder die Veröffentlichung eines neuen LLM noch der Beweis, dass jedes beliebige Modell auf einem Smartphone schnell läuft.
Was Version 1.0 tatsächlich verspricht
Die wichtigste Änderung ist eine explizite Semantik für die öffentlichen C-APIs: Ein großer Versionssprung signalisiert inkompatible Änderungen, kleinere Updates stehen für rückwärtskompatible Erweiterungen und Patches für Fehlerkorrekturen. Entwickler können dadurch besser einschätzen, wann Integrationen angepasst werden müssen.
Das Projekt benennt libllama und libggml separat. Bestehende Anwendungen sollten vor einem Upgrade Header, ABI, Kompilierung und alle genutzten Backends testen; die Kennzeichnung 1.0 allein ersetzt keinen Migrationstest.
Warum diese unscheinbare Änderung wichtig ist
Viele Anwendungen bauen auf derselben lokalen Inferenztechnik auf: Desktop-Assistenten, private Dokumentensuche und teils unternehmensinterne Workflows. Wenn zentrale Bibliotheken ihre Kompatibilitätsregeln verständlicher machen, können diese Produkte verlässlicher paketiert und langfristig gewartet werden.
Die Autoren nennen mehr als 150 unterstützte Architekturvarianten und verbreitete Methoden des spekulativen Decodings. Das beschreibt den breiten technischen Umfang, aber nicht eine unabhängige Leistungsgarantie für jede Kombination aus Modell und Hardware.
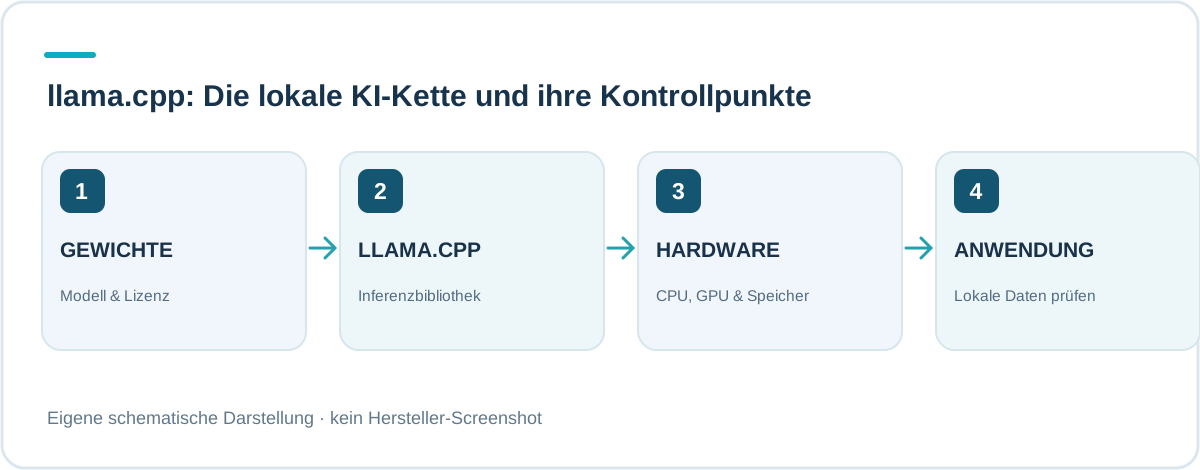
Privatsphäre beginnt beim tatsächlichen Datenfluss
Lokale Ausführung kann verhindern, dass Prompts oder interne Dokumente für jede Anfrage an einen externen Modellanbieter gesendet werden. Entscheidend ist aber, ob die gesamte Anwendung lokal bleibt: Plugins, Telemetrie, Modell-Downloads oder aktivierte Webwerkzeuge können weiterhin Netzwerkzugriffe auslösen.
Für sensible Daten empfiehlt AgentenCode einen konkreten Test: Netzwerkzugriffe kontrollieren, eingesetzte Modelle und Lizenzen dokumentieren, Updates nachvollziehbar installieren und den Zugriff auf Dateien und Systemfunktionen begrenzen. Mehr zur KI-Agenten-Sicherheit.
Hardwarevielfalt statt Herstellerbindung
llama.cpp und ggml setzen auf eine portable C/C++-Basis mit optimierten Backends und Quantisierung. Dadurch lassen sich offene Modelle an verschiedene Chips und Speicherbudgets anpassen, ohne dass sämtliche Anwendungen auf einen einzigen Cloudanbieter zugeschnitten werden müssen.
Quantisierung reduziert häufig den Speicherbedarf, kann aber Qualität und Laufzeit beeinflussen. Ein fairer Vergleich prüft Modell, Kontextfenster, Quantisierungsvariante, Tokenrate und Antwortqualität auf genau dem vorgesehenen Gerät.
Für wen Version 1.0 besonders interessant ist
Für Softwarehersteller wird die Einbettung in eigene Anwendungen planbarer. Unternehmen erhalten eine robuste Grundlage, um interne Such- und Zusammenfassungswerkzeuge in ihrer eigenen Infrastruktur zu prüfen. Privatnutzer profitieren indirekt, wenn Desktop-Apps aktualisierte Bibliotheken einbinden.
Wer keinen Code schreibt, muss Version 1.0 nicht manuell kompilieren. Häufig ist der sichere Weg ein vom jeweiligen App-Anbieter getestetes Update mit dokumentierter Modellunterstützung und klaren Dateneinstellungen.
Was die Release-Nummer gerade nicht garantiert
Version 1.0 bedeutet nicht, dass alle Erweiterungen stabil oder alle Sicherheitsrisiken erledigt sind. Die offiziellen Release Notes dokumentieren Änderungen an Bibliothek, Server und Werkzeugen; einzelne Komponenten benötigen weiterhin genaue Versions- und Konfigurationsprüfungen.
Auch die Modellgewichte haben eigene Lizenzen. Offene Inferenzsoftware macht das verwendete Modell nicht automatisch frei verwendbar, nicht automatisch datenschutzkonform und nicht automatisch sicher gegen Prompt Injection.
AgentenCode-Einordnung: Ein Infrastrukturereignis mit Wirkung
Während Schlagzeilen häufig neue Modellbenchmarks vergleichen, verbessert dieser Schritt die Basis, auf der viele offene und private KI-Anwendungen laufen. Das ist ein anderer, aber langfristig bedeutender Fortschritt: weniger Integrationsunsicherheit statt bloß größerer Parameterzahlen.
Die reale Wirkung zeigt sich erst bei den nächsten Updates: Halten Abwärtskompatibilität, Paketierung und Tests den neuen Regeln stand, stärkt llama.cpp das offene KI-Ökosystem deutlich.
Häufige Fragen
Ist llama.cpp 1.0 selbst ein neues KI-Modell?
Nein. Es ist die Version einer offenen Inferenzbibliothek, mit der unterschiedliche Modelle ausgeführt werden können.
Sind Daten bei lokaler KI automatisch privat?
Nicht zwingend. Netzwerkfähige Tools, Telemetrie, Downloads und weitere App-Dienste müssen separat kontrolliert werden.
Muss ich sofort aktualisieren?
Nicht ohne Tests. Besonders Entwickler sollten ABI, Backends und eigene Integrationen gegen die neue Version prüfen.
Bedeutet 1.0 gleiche Geschwindigkeit auf allen Geräten?
Nein. Leistung hängt von Modellarchitektur, Quantisierung, Speicher und Hardware ab.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- ggml-org / Hugging Face – llama.cpp v1.0.0: A stronger foundation for the local AI ecosystem, 13 November 2026
- ggml-org – llama.cpp v1.0.0 official release
- ggml-org – ggml v1.0.0 official release
Stand: 14. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.