
OpenAI testet KI bei COBOL-Migration: 86,6 statt 5,4 Prozent
OpenAI meldet große Fortschritte bei COBOL, Fortran und Visual Basic. Was MultiLangBench misst, welche Ergebnisse belastbar sind und was noch fehlt.
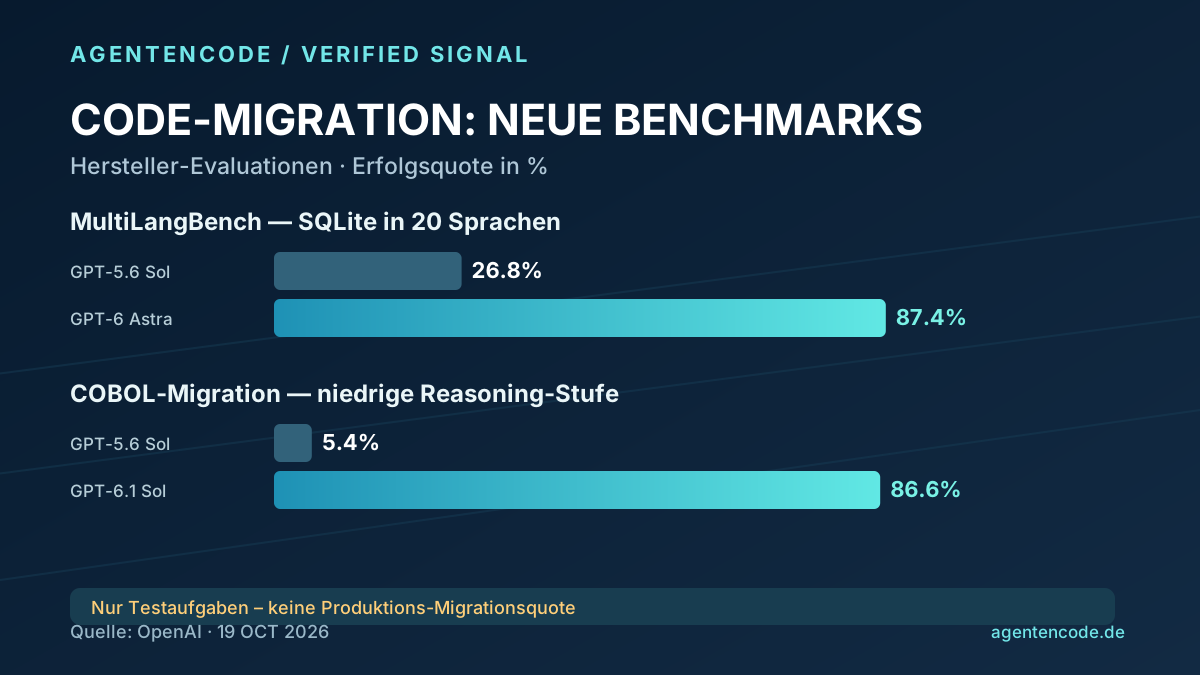
OpenAI hat am 19. Oktober neue Evaluationen für seltene oder historisch gewachsene Programmiersprachen vorgestellt. Auf einer eigenen COBOL-Migrationsaufgabe erreichte GPT-6.1 Sol laut Anbieter 86,6 Prozent korrekte Ergebnisse mit geringer Denkintensität, gegenüber 5,4 Prozent für GPT-5.6 Sol. Auf MultiLangBench erzielte GPT-6 Astra im Schnitt 87,4 Prozent bestandene Tests über 20 Sprachen. Beide Zahlen stammen aus OpenAI-eigenen Benchmarks und belegen keine risikofreie Migration produktiver Altsysteme.
Coding-Modelle arbeiten oft besser in stark verbreiteten Sprachen wie Python oder JavaScript. COBOL, Fortran und ältere Unternehmensprogramme verfügen über weniger öffentliche Trainingsbeispiele und komplizierte Fachregeln.
Neue Sprach- und Migrationstests erfassen längere Entwicklungsaufgaben und die exakte Bewahrung bestehender Programmeigenschaften. OpenAI veröffentlicht Prüfaufbau und Ergebnisse, berichtet aber primär über eigene Modelle.
Zwei Benchmarks messen unterschiedliche Fähigkeiten
MultiLangBench verlangt nicht bloß einen passenden Code-Schnipsel: Modelle sollen in 20 Programmiersprachen einen SQLite-kompatiblen Datenbankkern entwickeln. Die erzeugten Datenbankdateien werden mit einer Referenzimplementierung verglichen. Auf dieser Aufgabe meldet OpenAI für GPT-6 Astra durchschnittlich 87,4 Prozent bestandene Tests, gegenüber 26,8 Prozent für GPT-5.6 Sol. Die Vergleiche verwenden definierte Modell- und Denkbudgets und beziehen sich auf genau diesen Prüfaufbau, nicht auf beliebige Softwareprojekte.
Die zweite Evaluation testet die Übersetzung bestehender COBOL-Programme nach C++, Java, Kotlin, Python oder Rust. Entscheidend ist die Erhaltung beobachtbarer Ausgaben, einschließlich stiller Geschäftsregeln etwa bei Geldbeträgen und Rundungsverhalten. OpenAI gibt für GPT-6.1 Sol bei geringer Denkintensität 86,6 Prozent an, für GPT-5.6 Sol 5,4 Prozent; bei höherem Denkbudget steige die neue Modellleistung auf 97,9 Prozent. Auch das ist eine Testquote, keine Produktionsabnahme.
Warum insbesondere COBOL und Fortran wichtig sind
In Bank-, Versicherungs- und Verwaltungssoftware stecken Regeln, die oft nie vollständig in einer aktuellen Dokumentation festgehalten wurden. Eine automatische Migration kann syntaktisch korrekt sein und dennoch Geldbeträge anders runden, Sonderfälle falsch behandeln oder Abhängigkeiten übersehen. Die Stärke der neuen Evaluation liegt darin, solche Verhaltensabweichungen über verborgene Tests sichtbar machen zu wollen. Die Grenze: Ein endlicher Testkatalog kann nicht jede betriebliche Ausnahme eines jahrzehntealten Systems abdecken.
Auch Fortran und Visual Basic bleiben für wissenschaftliche oder betriebliche Anwendungen relevant. OpenAI berichtet bei MultiLangBench für Fortran einen Anstieg von 21,4 auf 83,5 Prozent, für Visual Basic von 27,5 auf 89,4 Prozent. Solche Werte können Entwicklerteams helfen, Pilotfälle auszuwählen. Sie erlauben aber keinen direkten Vergleich zwischen Anbietern oder einen Schluss auf vollständige Sicherheit; dafür wären unabhängige Replikationen und projektspezifische Regressionstests nötig.
Wie Unternehmen einen KI-Migrationspilot prüfen sollten
Der sinnvollste Einsatz ist ein eng abgegrenzter Teil eines bestehenden Systems. Zuerst werden reale Ein- und Ausgaben, Grenzfälle, numerische Genauigkeit und bekannte Ausnahmen als unveränderliche Referenz erfasst. Danach lässt man ein Coding-Modell eine Übersetzung vorschlagen, die ein Team gegen diese Referenz testet. Fachverantwortliche müssen erklären können, warum jede Änderung das alte Verhalten erhält. Ein erfolgreiches Benchmark-Ergebnis ersetzt weder Code-Review noch Parallelbetrieb.
OpenAI stellt den MultiLangBench-Aufbau nach eigenen Angaben öffentlich zur Verfügung. Das ist ein guter Ansatz für reproduzierbare Vergleiche, sofern konkrete Versionen, Kosten, Tests und Laufzeitumgebung dokumentiert werden. AgentenCode würde bei einer Beschaffung getrennt messen: erzeugt der Agent lauffähigen Code, bleiben Geschäftsergebnisse identisch, sinkt der tatsächliche Aufwand inklusive Nacharbeit, und lassen sich Fehler später zurückverfolgen? Erst diese Kombination zählt für eine belastbare Modernisierungsentscheidung.
AgentenCode-Einordnung
Die Nachricht ist bedeutender als ein Modell-Ranking: KI-Coding verschiebt sich in Sprachen, in denen Fachwissen teuer und Dokumentation knapp ist. Die OpenAI-Ergebnisse machen Fortschritte messbar, aber sie sind vom Hersteller erhoben und testabhängig. Für Banken oder Behörden wäre die falsche Folgerung „97,9 Prozent – also automatisch migrieren“. Der richtige Schluss ist: Jetzt könnten sorgfältig begrenzte Vergleichspiloten lohnender werden.
Quellen und Prüfung
Redaktionell geprüft anhand der offiziellen OpenAI-Forschung vom 19. Oktober 2026. Benchmark-Ergebnisse und Kostenschätzungen sind Anbieterangaben; keine unabhängige Nachmessung, kein Nachweis für Produktionsparität.