
LifeVal: OpenAI misst Alltagsagenten – warum hohe Testwerte noch keinen echten Erfolg beweisen
Wie gut hilft KI beim Finden einer Kita, Organisieren von Freiwilligen oder Planen eines Haushalts? OpenAI hat am 2. November 2026 LifeVal vorgestellt. Die Evaluation richtet den Blick auf Aufgaben, die Menschen im Alltag tatsächlich interessieren. Entscheidend ist jedoch, was als Erfolg zählt: eine bewertete Modellantwort ist noch keine in der Außenwelt bestätigte Handlung.
LifeVal ist eine neue OpenAI-Evaluation für praktische Alltagsaufgaben, gestützt auf vorhandene Zeitverwendungsstudien und eine Befragung von 3.995 Menschen. Die veröffentlichten Prozentwerte beziehen sich auf ausgewählte Beispiele, nicht auf eine nachgewiesene allgemeine Erfolgsquote autonomer Alltagsagenten. Wer echte Anwendungen beurteilt, muss zusätzlich korrekte Aktionen, Zustimmung, Datenschutz und überprüfbare Ergebnisse messen.
Quellenlage und Grenzen
- Primärquelle
Originalpublikation von OpenAI vom 2. November 2026 mit Befragungszahl, Aufgabenfeldern und exemplarischen Ergebnissen. Original lesen.
- Nicht unabhängig geprüft
Weder ein unabhängiger Nachtest noch eine vollständige Erfolgsquote realer End-to-End-Handlungen liegt unserer Analyse zugrunde.
LifeVal beurteilt Aufgaben statt nur Antworten
OpenAI beginnt mit einer sinnvollen Frage: Welche Unterstützung wünschen Menschen wirklich? Für LifeVal greift das Unternehmen auf die American Time Use Survey und die Multinational Time Use Study zurück. Hinzu kommt eine nach OpenAI-Angaben demografisch repräsentative Befragung von 3.995 Personen. Die Aufgaben betreffen unter anderem Betreuung, Bildung, Haushaltsorganisation, persönliche Finanzen, Einkäufe und Behördenkontakte.
Die Verschiebung ist wichtig: Klassische Modelltests bewerten häufig Wissen, Mathematik oder Code. Eine Privatperson benötigt dagegen oft einen nachvollziehbaren Plan, den passenden Antrag oder eine verlässliche Entscheidungsvorbereitung. Die Quelle beschreibt LifeVal als Evaluation, mit der OpenAI seine Modelle entwickelt und Fortschritt verfolgt. Sie kündigt damit keinen universell verfügbaren Agenten an, der alle Beispiele selbstständig abschließen kann.
Was die 93,1 und 98,0 Prozent tatsächlich zeigen
OpenAI nennt für die vorgestellte Aufgabe, passende Kindergärten nach einem Umzug zu vergleichen, 93,1 Prozent. Für die Organisation von Freiwilligen zur Hochwasservorbereitung werden 98,0 Prozent gezeigt; ein Beispiel zur Wohnungssuche erreicht in der Darstellung 100 Prozent. Solche Einzelwerte illustrieren den gewählten Bewertungsansatz, dürfen aber nicht als Gesamtwert für LifeVal oder als Erfolgswahrscheinlichkeit in beliebigen Haushalten gelesen werden.
Die Beispielantwort zur Kita bietet eine Vorauswahl und verweist ausdrücklich auf noch offene Entscheidungen der Eltern. Auch das Beispiel zu medizinisch geprägter Essensplanung führt zu einem Vorschlag und zur Abstimmung mit dem Behandlungsteam. Die entscheidende Lesart lautet: Das System unterstützt einen Prozess. Ob eine Einrichtung tatsächlich Plätze anbietet, eine reale Hilfe organisiert wurde oder ein Antrag erfolgreich eingereicht ist, folgt aus diesen Screenshots nicht.
Warum ein guter Testwert keine erledigte Handlung ist
Eine Evaluation kann eine Modellleistung an einem definierten Aufgabenfall messen. Ein echter Agent muss zusätzlich aktuelle Quellen abrufen, Berechtigungen einhalten, mit veränderten Webseiten umgehen, Termine bestätigen und Auswirkungen dokumentieren. Der Sprung zwischen beidem ist kein nebensächliches Detail, sondern die Differenz zwischen einer guten Assistenz und einem zuverlässig abgeschlossenen Auftrag.
Eine besonders hilfreiche Veröffentlichung würde daher die Aufgaben nicht nur nach Antwortqualität, sondern auch nach Aktionserfolg, Fehlerfolgen und erforderlichem menschlichem Eingriff aufschlüsseln. Diese Kennzahlen können wir aus der öffentlich präsentierten Kurzbeschreibung nicht als vollständige unabhängige End-to-End-Statistik ableiten. AgentenCode kennzeichnet diese Lücke ausdrücklich statt die hohen Beispielprozente zu überdehnen.
Was bei sensiblen Alltagsaufgaben zusätzlich zählt
Gerade bei Betreuungsplätzen, Gesundheit, Geld und Behörden kann ein sprachlich überzeugender Vorschlag erhebliche Folgen haben. Ein Agent, der nur recherchiert, braucht andere Rechte als ein Agent, der Verträge abschließt, Zahlungen auslöst oder persönliche Dokumente übermittelt. Sinnvoll ist deshalb eine getrennte Freigabe je Wirkungsstufe: Informationen sammeln, Empfehlungen vorbereiten, reale Transaktionen ausführen.
Auch die Datensparsamkeit muss Teil des Tests sein. Familien- und Gesundheitsinformationen sollten nicht als vermeintlich harmlose Beispiele unkontrolliert in externe Werkzeuge gelangen. Vor einer produktiven Nutzung gehört dokumentiert, welche Daten an welche Dienste gehen, wie aktuell Quellen sind, wer vor kritischen Schritten bestätigt und wie Fehler zurückgenommen werden können.
AgentenCode-Matrix: Von der Bewertung zur Freigabe
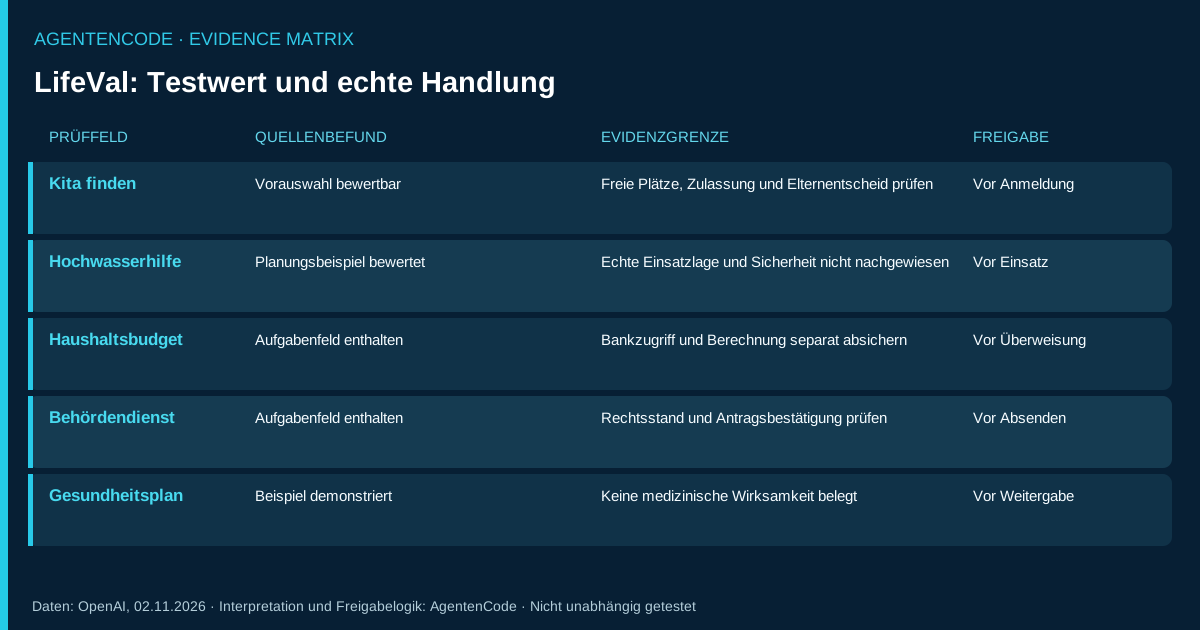
Unsere Matrix ist keine von OpenAI veröffentlichte LifeVal-Wertung. Sie übersetzt die belegten Beispielaufgaben in prüfbare Freigabefragen. Damit wird aus einer interessanten Forschungsankündigung eine Entscheidungshilfe für Entwickler, Familien und Organisationen.
Die Trennlinie ist jeweils dieselbe: Eine gute Vorauswahl lässt sich häufig unter Aufsicht testen; reale Einschreibungen, Zahlungen oder Hilfseinsätze benötigen zusätzliche Verifikation. Erst ein nachweisbar korrektes Ergebnis außerhalb des Modells würde die Behauptung einer vollständig erledigten Aufgabe tragen.
| Fall | Quellenbefund | Offene Prüfung | Freigabepunkt |
|---|---|---|---|
| Kita finden | Vorauswahl bewertbar | Freie Plätze, Zulassung und Elternentscheid prüfen | Vor Anmeldung |
| Hochwasserhilfe | Planungsbeispiel bewertet | Echte Einsatzlage und Sicherheit nicht nachgewiesen | Vor Einsatz |
| Haushaltsbudget | Aufgabenfeld enthalten | Bankzugriff und Berechnung separat absichern | Vor Überweisung |
| Behördendienst | Aufgabenfeld enthalten | Rechtsstand und Antragsbestätigung prüfen | Vor Absenden |
| Gesundheitsplan | Beispiel demonstriert | Keine medizinische Wirksamkeit belegt | Vor Weitergabe |
So lässt sich ein realer Alltagsagent prüfen
Ein belastbarer Pilot braucht zunächst drei bis fünf klar abgegrenzte Aufgaben mit Einwilligung und geeigneten Testdaten. Für jeden Auftrag werden erwarteter Ausgang, erlaubte Werkzeuge, notwendige Freigaben und Abbruchbedingungen festgelegt. Dann prüft man nicht nur das Enddokument, sondern auch die verwendeten Quellen, Änderungen an externen Systemen und den Zeitaufwand für Korrekturen.
Anschließend werden reale Erfolgsfälle und Fehlschläge getrennt dokumentiert: Wurde die richtige Kita kontaktiert? War der Antrag gültig? Musste eine Person eingreifen? Ohne solche Logs bleibt eine Prozentzahl aus einer Modell-Evaluation ein Hinweis auf Fähigkeit, nicht der Beweis für verlässliche praktische Autonomie. Wir haben diese Tests selbst nicht durchgeführt.
Fazit: Der entscheidende Maßstab bleibt das Ergebnis
LifeVal ist aus redaktioneller Sicht relevant, weil es die Diskussion weg von abstrakter Modellintelligenz hin zu menschlich nützlichen Aufgaben lenkt. Das ist ein Fortschritt bei der Wahl des Bewertungsgegenstands, keine Garantie, dass Agenten schon sicher im Alltag handeln.
Die nächste wichtige Frage lautet daher nicht nur, wie hoch der veröffentlichte Score ist, sondern welche Aufgaben mit echten Werkzeugen, korrekten Rechten, nachvollziehbarer menschlicher Zustimmung und überprüfbarem Ergebnis zuverlässig erledigt werden. Genau diese Grenze sollten Leser beim Vergleich von Alltagsagenten beachten.
Originalquellen
- OpenAI, LifeVal (2 November 2026) – offizielle Erstveröffentlichung und Bezugsquelle der beschriebenen Angaben.
Häufige Fragen
Beweist LifeVal, dass KI-Agenten ihren Alltag autonom erledigen können?
Nein. Die Veröffentlichung zeigt eine modellbezogene Evaluation und ausgewählte Aufgabenbeispiele. Die erfolgreiche Ausführung realer Transaktionen wird dadurch nicht pauschal nachgewiesen.
Sind die Prozentzahlen eine allgemeine Erfolgsquote?
Nein. Die sichtbaren Werte gehören zu vorgestellten Aufgabenbeispielen. Sie dürfen nicht als übergreifende reale Erfolgsrate ausgegeben werden.
Wie viele Menschen wurden zusätzlich befragt?
OpenAI beschreibt eine demografisch repräsentative Befragung mit 3.995 Teilnehmenden zur Priorisierung relevanter Alltagsaufgaben.