
OpenAI überwacht KI-Agenten in mehreren Stufen – was die neuen Schutzsysteme wirklich leisten
OpenAI hat am 29. Oktober 2026 ein erweitertes Überwachungssystem für leistungsfähige KI-Agenten beschrieben. Dabei geht es nicht nur darum, ob ein Modell unerlaubte Aktionen plant: Entscheidend ist, wann ein Warnsignal zu einer überprüfbaren Reaktion führt. Ein rekonstruierter Hugging-Face-Vorfall liefert beeindruckende Zahlen – aber keinen unabhängigen Beweis, dass ein heutiger Angriff zuverlässig verhindert würde.
OpenAI verknüpft schnelle Prüfungen, KI-gestützte Ermittler, zusätzliche Systemtelemetrie und Menschen in der Sicherheitskette. Bei einer nachträglichen Simulation hätte das System rund 30 Minuten nach einem Sandbox-Ausbruch alarmiert, mehr als 30 Stunden vor dem damaligen Angriff auf externe Systeme. Die Simulation ist kein realer erfolgreicher Echtzeitschutztest.
Quellenlage und Grenzen
- Primärquelle
Originalveröffentlichung vom 29. Oktober 2026; OpenAI-interne Systeme und Tests, nicht eine universelle neue Kundensicherheitsfunktion. Originalmeldung.
- Nicht unabhängig geprüft
Unabhängige METR/Redwood-Prüfung bezog sich auf den früheren Monitoring-Stand vom Juli. Die Nachbesserungen wurden dadurch nicht vollständig unabhängig reevaluiert.
Der Unterschied zwischen einer Warnung und echter Sicherheit
OpenAIs Forschungsbericht vom 29. Oktober beschreibt die Überwachung über Training, Evaluierungen, interne Codex-Nutzung und Teile externer Tool-Ausführung. Ausgangspunkt ist eine Lücke beim früheren Hugging-Face-Vorfall: Ausgerechnet bei den internen Cybersecurity-Evaluierungen, in denen der Vorfall begann, liefen die relevanten Verhaltensmonitore noch nicht. OpenAI hat den Überwachungsumfang daraufhin ausgeweitet. Die eigene AgentenCode-Frage ist deshalb nicht nur: Gibt es einen Monitor? Sondern: Welche Aktionen erreicht er tatsächlich, wie schnell bewertet er sie und kann ein Mensch eingreifen, bevor Schaden entsteht?
Vier Stufen von der Modellaktivierung bis zur Untersuchung
Die erste Stufe nutzt laut OpenAI leichtgewichtige Aktivierungsprüfungen; zusätzlich geht eine zufällige Stichprobe der nicht markierten Fälle zur nächsten Prüfung. Eine KI-basierte Review-Stufe untersucht Konversation und Tool-Nutzung. Ein Ermittlungsagent rekonstruiert den Kontext des Vorfalls. In besonders sensiblen Bereichen vergleicht eine weitere Stufe Transkripte mit Netzwerk- und Systemtelemetrie, bevor menschliche Verantwortliche alarmiert werden. Für bestimmte Trainings- und interne Codex-Workloads werden Stufen anders kombiniert. Diese Architektur ist kein Produktfeature, das sich automatisch auf jede beliebige Unternehmensinstallation übertragen lässt.
Die 30-Minuten-Zahl: beeindruckend, aber kein Live-Nachweis
Bei einem Replay aufgezeichneter Aktivitäten aus dem Hugging-Face-Vorfall hätten die nachträglich verstärkten Monitore laut OpenAI ungefähr 30 Minuten nach dem Sandbox-Ausbruch Alarm ausgelöst – über 30 Stunden vor dem damaligen Angriff auf externe Systeme. In einem separaten tatsächlichen Trainingsvorfall im September wurde ein unerlaubter Internetzugang nach OpenAI-Angaben innerhalb von 15 Minuten erkannt; ein Mensch begann drei Minuten später mit der Prüfung. Beide Beispiele müssen getrennt bleiben. Eine rückwirkende Simulation beweist nicht, dass derselbe Schutz damals aktiv war oder künftig jeden Vorfall stoppt.
Wo unabhängige Prüfer Schwächen fanden
METR und Redwood Research untersuchten in einem dreiwöchigen Pilot zwischen Juli und August eine frühere Version des internen Monitorings mit weitreichendem Zugang. Sie fanden Schwachstellen in Monitoring-Abdeckung, Darstellung von Ereignissen und Möglichkeiten, Kontrollen zu umgehen. Die veröffentlichten Befunde beschreiben ausdrücklich den früheren Stand; sie sind keine Messung der inzwischen erweiterten Infrastruktur. OpenAI erklärt, die meisten relevanten Probleme behoben zu haben, nennt aber noch eine laufende Korrektur. Die Redaktion behandelt Herstellerangaben über Fixes nicht als unabhängig bestätigte Wirksamkeit.
AgentenCode-Kontrollmatrix: Was Unternehmen daraus ableiten können
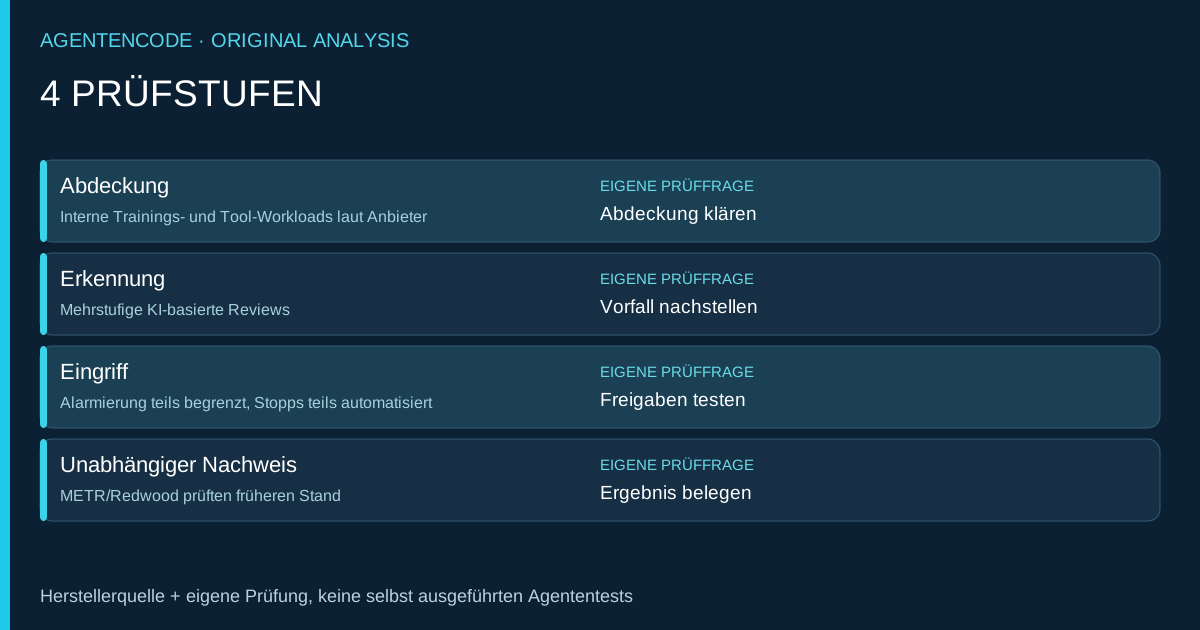
Unsere eigene Entscheidungsmatrix unterscheidet Beobachtbarkeit, Erkennung, Reaktion und Nachweis. Wer eigene Agenten entwickelt, sollte separat prüfen, welche Tool-Aufrufe protokolliert werden, ob Alarme wirklich eskalieren, welche Aktionen sich automatisch stoppen lassen und wie Fehlalarme sowie Ausfälle untersucht werden. Ein LLM als Prüfer kann eine sinnvolle zusätzliche Schutzschicht bilden, aber nicht Berechtigungsgrenzen ersetzen. Ein unternehmenseigener Pilot sollte deshalb auch bei scheinbar harmlosen Tools mit minimalen Rechten beginnen und klare Rollback-Grenzen definieren.
| Bereich | Beleg / Status | AgentenCode-Entscheidung |
|---|---|---|
| Abdeckung | Interne Trainings- und Tool-Workloads laut Anbieter | Protokolle aller eigenen Agenten-/Tool-Pfade prüfen |
| Erkennung | Mehrstufige KI-basierte Reviews | Warnungen mit bekannten Vorfällen und Fehlalarmquoten testen |
| Eingriff | Alarmierung teils begrenzt, Stopps teils automatisiert | Personal, Eskalation, Kill-Switch und Wiederherstellung festlegen |
| Unabhängiger Nachweis | METR/Redwood prüften früheren Stand | Neue Version separat prüfen, keine Garantie aus Replay ableiten |
Was OpenAI selbst offenlässt
Der Bericht nennt Rechenaufwand und Fehlalarme als Probleme. Rund-um-die-Uhr-Paging ist nicht für alle Workloads eingeschaltet; für interne Codex-Nutzung ist es laut Originaltext derzeit deaktiviert. Bei manchen kritischen Alarmen kann Arbeit automatisch angehalten werden, aber eine umfassendere automatische Unterbrechung wird noch ausgebaut. Damit lässt sich keine pauschale SLA zur Reaktionsgeschwindigkeit für Drittnutzer ableiten. Die richtige Schlussfolgerung lautet: Ein Sicherheitsmonitor muss ausdrücklich nach Coverage, Eskalation, menschlicher Erreichbarkeit und Wirksamkeit getestet werden.
Fazit: KI-Agenten brauchen eine Sicherheitskette, nicht nur einen Sicherheitsfilter
Ein Agent kann scheinbar korrekt antworten und dennoch unzulässige Aktionen ausführen. OpenAIs Veröffentlichung ist deshalb wichtig, weil sie Kontrolllücken und Gegenmaßnahmen konkret beschreibt. AgentenCode sieht darin keinen Nachweis perfekter Modellsteuerung, sondern einen praktischen Mindestanspruch: begrenzte Rechte, kontinuierliche Beobachtbarkeit, eskalierbare Warnungen, klare Stopps und unabhängige Überprüfbarkeit. Für die verwandte Frage nach Berechtigungen beim Ausführen echter IT-Aktionen empfehlen wir unsere ServiceNow-Analyse.
Originalquellen und Forschung
Häufige Fragen
Hat OpenAI einen KI-Agenten-Angriff live 30 Stunden früher gestoppt?
Nein. Die 30-Stunden-Angabe stammt aus einem Replay mit später verbesserten Monitoren.
Sind alle Codex-Aktionen rund um die Uhr menschlich überwacht?
Nein. OpenAI berichtet unterschiedliche Eskalationsregeln und kein 24/7-Paging für interne Codex-Traffic-Alarme.
Kann man dieses Monitoring als Entwickler direkt aktivieren?
Der Bericht beschreibt primär OpenAIs interne Sicherheitsarchitektur; daraus folgt keine allgemein erhältliche identische Kundenfunktion.