
Perplexity Decider v1.3: Eine neue KI bewertet Fakten, erkennt Daten und spart Rechenkosten
Perplexity veröffentlicht Decider v1.3 und Flash als offene Entscheidungsmodelle. Locate extrahiert Textstellen; Benchmarks, Kosten und Grenzen erklärt.
Nicht jede Frage braucht einen Chatbot
Eine KI muss nicht für jede kleine Aufgabe lange Antworten schreiben. In einer Suchmaschine werden Dokumente sortiert, Texte moderiert, Eingaben an passende Modelle geleitet und Aussagen auf Plausibilität geprüft. Dafür veröffentlicht Perplexity Decider v1.3 und die kleinere Flash-Version: spezialisierte Modelle, die Wahrscheinlichkeiten für Entscheidungen berechnen.
Sie ersetzen keine allgemeine Sprachassistenz und fällen keine rechtsverbindlichen Urteile. Ihre Stärke liegt in wiederholbaren Klassifizierungs- und Bewertungsfragen, bei denen ein frei formulierter Text oft weder notwendig noch wünschenswert ist. Das ist eine andere Entwicklungsrichtung als stets größere generative Modelle.
Die neue Funktion locate findet konkrete Textstellen
Mit locate kann eine Anwendung einen Text nicht nur als relevant oder irrelevant einstufen, sondern die genaue Passage zurückerhalten, etwa einen Firmennamen, eine E-Mail-Adresse oder eine Vertragsfrist. Laut Herstellerbeschreibung werden Start- und Endpositionen der gefundenen Zeichen geliefert. In einer Anfrage lassen sich Extraktion, Kategorien und Bewertungen kombinieren.
Das ist etwa für Vertragsprüfung, Dokumentenextraktion und kontrollierte Recherche interessant. Allerdings ist ein markierter Textspan noch kein Beweis, dass der Inhalt wahr oder rechtlich wirksam ist. Auch die Erkennung personenbezogener Daten kann Fehler haben: Kritische Ergebnisse erfordern zusätzliche Regeln und menschliche Freigabe.
Technischer Ansatz: Lesen statt Token für Token schreiben
Decider nutzt ein Sprachmodell-Backbone mit einem spezialisierten Entscheidungskopf. Anstelle einer langen frei generierten Antwort bewertet es vordefinierte Antwortoptionen, etwa Ja/Nein oder mehrere Klassen. Perplexity beschreibt bidirektionale Aufmerksamkeit und isolierte Fragebereiche, damit Ergebnisse stabiler bleiben, wenn eine Eingabe mehrere Kriterien gleichzeitig enthält.
Das neue locate-Modul wurde mit einem separaten Adapter und Span-Head trainiert. Perplexity erklärt, dass ein Zusammenführen mit dem Kernmodell noch Leistung bei anderen Fragen verschlechtern kann; deshalb bleibt die Erweiterung getrennt. Diese dokumentierte Grenze ist wichtig, weil ein Mehrzweckmodell nicht überall gleichzeitig verbessert werden muss.
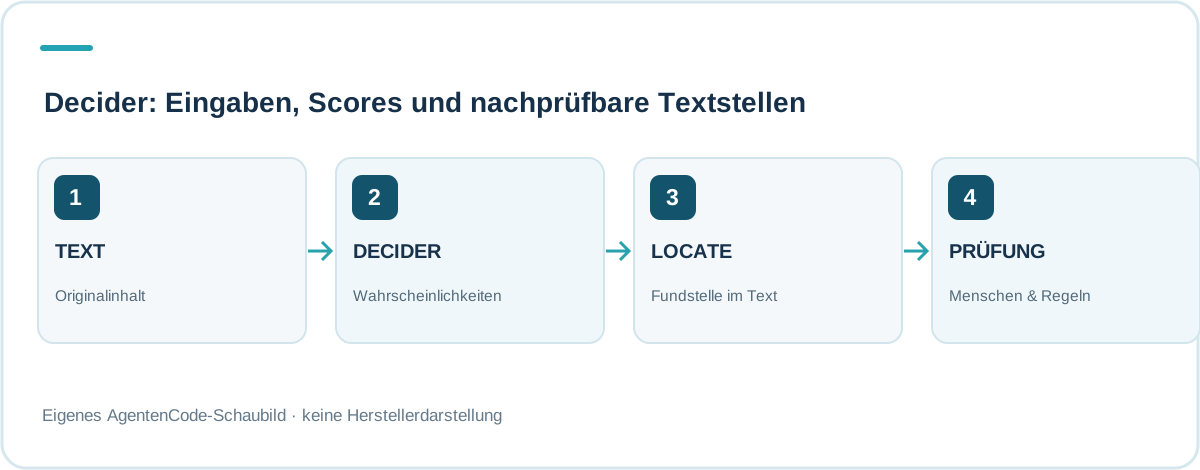
91,6 Prozent im Herstellervergleich – was das sagt
Perplexity meldet für Decider v1.3 eine mittlere Genauigkeit von 91,6 Prozent über 63 intern zusammengestellte Klassifizierungsaufgaben, rund 6,54 Prozentpunkte besser als eigene Produktionsklassifikatoren. Auf 72 Retrieval-Aufgaben nennt das Unternehmen einen mittleren nDCG@10 von 83,99, ungefähr 1,81 Punkte vor Qwen3-Reranker-8B.
Diese Kennzahlen stammen aus vom Anbieter zusammengestellten Auswertungen und unterschiedlichen Testumgebungen. Sie belegen nicht, dass Decider 91,6 Prozent aller Unternehmensentscheidungen richtig trifft. Benchmark-Definitionen, Trainingsüberschneidungen und die Auslegung von Ground Truth können Resultate verschieben.
Günstiger, aber nicht automatisch immer billiger
Perplexity stellt eine Modellrechnung für eine Million eigener Anfragen vor: rund 26,47 US-Dollar für Decider v1.3 und 13,24 Dollar für Flash v1.3 unter den dort zugrunde gelegten Bedingungen. Die gezeigten Kosten anderer Modelle beruhen teilweise auf API-Aufrufen, während Decider lokal lief.
Das ist keine unabhängige Marktpreisliste. Ohne gleichartige Hardware-, Strom-, Batch- und Latenzmessungen sind solche Werte nicht direkt vergleichbar. Der größere Effekt könnte aus einer anderen Arbeitsaufteilung stammen: Große Modelle lösen komplexe Fragen, kleine Entscheidungsmodelle erledigen häufige Sortier- und Kontrollaufgaben.
Offene Gewichte und mehrere Zugänge
Laut Perplexity sind die beiden Modelle auf Hugging Face unter Apache-Lizenz veröffentlicht und zusätzlich über OpenRouter sowie die Decisions API nutzbar. Die größere Variante basiert auf einem Qwen3.8-27B-Backbone, die Flash-Ausgabe auf einem kleineren 4B-Modell. Entscheidend ist dabei auch die genaue Lizenz des jeweiligen Repositories und seiner Abhängigkeiten.
Für Entwickler macht das eigene Bereitstellung und reproduzierbare Versuche möglich. Dennoch unterscheiden sich Kosten, Datenhaltung und technische Anforderungen zwischen lokalem Betrieb, Cloud-Provider und API. Für Datenschutz und Sicherheit zählen die tatsächlichen Netzwerkzugriffe und Verarbeitungsverträge, nicht nur das Wort offen.
Warum das für Sicherheit und Qualität interessant ist
Perplexity berichtet über den Einsatz seiner Entscheidungsmodelle beim Überprüfen von Agentenprotokollen: Ein Modell sucht nach möglicherweise übersehenen Regelverstößen oder unnötigen Alarmen, danach schlagen andere Schritte Regelanpassungen vor. Laut Anbieter werden Änderungen erst nach menschlicher Prüfung wirksam. Dadurch entsteht eine nachvollziehbare Arbeitsteilung zwischen schnellen Regeln, statistischer Klassifikation und Verantwortlichen.
Bei Prompt Injection und fehlerhaften Tools kann ein Klassifikator ebenfalls getäuscht werden. Für KI-Agenten-Sicherheit müssen Freigaben, unveränderliche Logs, Testdaten, Fehlerraten und eine menschliche Eskalation erhalten bleiben. Ein Score darf niemals alleine eine irreversible Aktion legitimieren.
AgentenCode-Einordnung: Spezialisierung statt Modellgigantismus
Decider v1.3 ist ein Beispiel dafür, dass KI-Fortschritt zunehmend aus kleineren, spezialisierten Komponenten kommen kann. Genaues Extrahieren, Sortieren und Bewerten ist in realen Softwareprozessen häufig wichtiger als die Fähigkeit, lange Texte überzeugend zu formulieren. Die neue locate-Funktion macht Aussagen zudem leichter an sichtbaren Originalstellen überprüfbar.
Für einen seriösen Pilotversuch empfehlen sich präzise Aufgaben mit vorhandenen Referenzlabels, die getrennt nach Sprache und Dokumentenart geprüft werden. Berichtet werden sollten Fehlalarme, übersehene Fälle, Durchsatz, Hardwarekosten und die Wirkung menschlicher Kontrollen. Herstellerzahlen sind ein Ausgangspunkt, kein Ersatz für eigene Messungen.
Häufige Fragen
Ist Decider v1.3 ein gewöhnlicher Chatbot?
Nein. Es ist ein Modell für strukturierte Klassifikation, Bewertung, Ranking und Textstellenextraktion, nicht primär für freie Gespräche.
Was macht die Funktion locate?
Sie liefert die genaue Fundstelle eines angeforderten Textfragments mit Zeichenpositionen zurück, sofern ein Treffer erkannt wird.
Sind Decider v1.3 und Flash offen?
Perplexity stellt die Modelle laut Release auf Hugging Face unter Apache-Lizenz bereit; für den Einsatz zählen die konkreten Repository-Lizenzen und Abhängigkeiten.
Kann Decider Sicherheitsentscheidungen allein treffen?
Nein. Klassifikatorfehler, Datenverschiebungen und manipulierte Eingaben erfordern weitere Kontrollen und menschliche Verantwortung.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- Perplexity – Decider v1.3 research release (12 Nov 2026)
- Perplexity – Decider v1.3 official model card
- Perplexity – Decider Flash v1.3 official model card
- Perplexity – Decisions API documentation
Stand: 15. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.