
Salesforce SFR-AutoR&D: Wenn KI-Agenten Modelle durch Experimente verbessern
Salesforce SFR-AutoR&D automatisiert kontrollierte Modellforschung. Was 6,13 Punkte nDCG@10, 36 % mehr Durchsatz und 17 % weniger Latenz wirklich bedeuten.
1. Was Salesforce am 11. November tatsächlich vorgestellt hat
Der Name klingt nach einem Modell, dahinter steckt aber ein Prozess: SFR-AutoR&D ist ein System mehrerer spezialisierter KI-Agenten, das Forschungsentscheidungen in einen überprüfbaren Ablauf überführt. Menschen geben das Ziel, die zu bearbeitende Codebasis, verfügbare Daten, einen Evaluationsrahmen und ein Rechenbudget vor. Innerhalb dieses Rahmens entwerfen Agenten Ideen, setzen sie um, starten Experimente und vergleichen die Ergebnisse mit bereits bekannten Referenzwerten. Änderungen ohne belegten Fortschritt sollen nicht dauerhaft übernommen werden.
Salesforce berichtet, dass das System für Embedding-Modelle eingesetzt wird, die Informationen für unternehmensinterne KI-Anwendungen auffindbar machen. Das unterscheidet die Meldung von einer gewöhnlichen Coding-Agenten-Demonstration: Der Agent soll nicht nur Code liefern, sondern seine Wirkung auf ein messbares Modellziel nachweisen. Quelle: Salesforce, 11.11.2026.
2. Warum Retrieval für Agenten wichtiger sein kann als ein größeres Sprachmodell
Ein Agent kann noch so gut formulieren: Wenn seine Suche die falschen Vertragsklauseln, veraltete Richtlinien oder die unpassende Kundendokumentation findet, baut er seine Antwort auf schlechtem Kontext auf. Embedding-Modelle wandeln Inhalte und Anfragen in Repräsentationen um, die eine semantische Suche ermöglichen. Deren Güte beeinflusst, welche Treffer ein Agent überhaupt zu sehen bekommt.
In Salesforce Data Cloud spielt diese Retrieval-Schicht eine wichtige Rolle für datengestützte Agentforce-Anwendungen. Fortschritte können deshalb mehrere nachgelagerte Anwendungen betreffen, ohne dass deren zugrunde liegendes Sprachmodell ersetzt werden muss. AgentenCode-Einordnung: Eine bessere Retrieval-Metrik ist ein plausibler Hebel für fundiertere Agentenantworten; sie beweist jedoch weder weniger Halluzinationen noch höhere Genauigkeit im vollständigen End-to-End-Prozess.
3. Drei Zahlen, drei unterschiedliche Aussagen
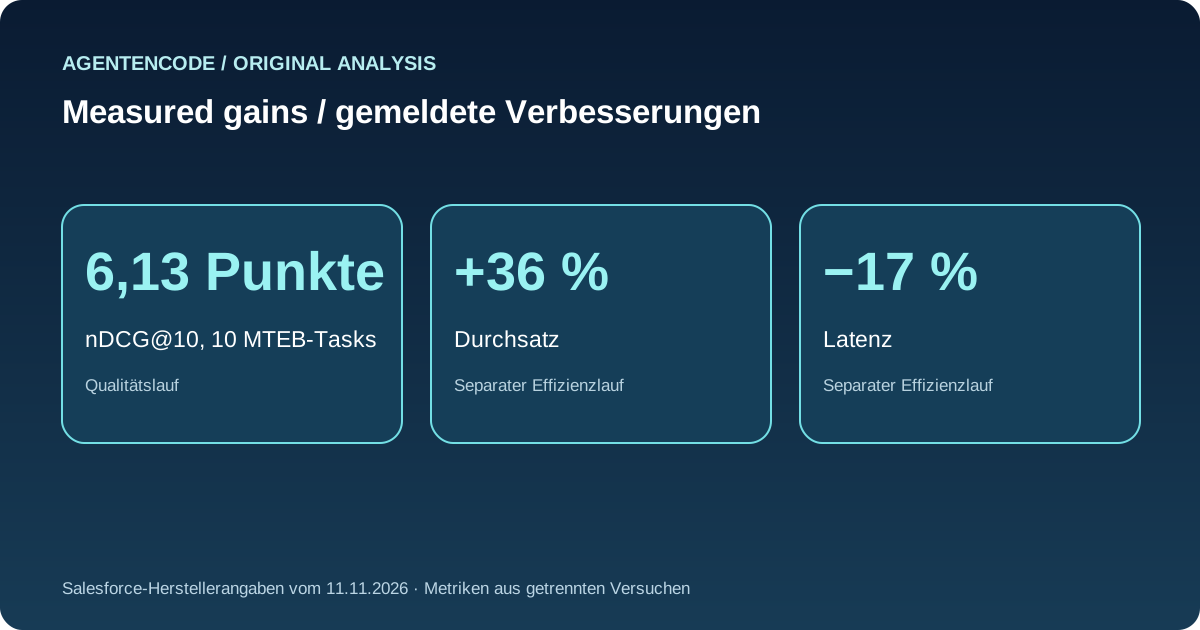
Salesforce nennt einen Forschungszyklus von ungefähr 80 Stunden, in dem SFR-AutoR&D die Modellverbesserung weitgehend eigenständig bearbeitete. Auf zehn öffentlichen Retrieval-Aufgaben aus MTEB stieg nach Unternehmensangaben der nDCG@10-Wert um 6,13 Punkte. Die Metrik bewertet, wie weit oben relevante Dokumente in den ersten zehn Suchergebnissen erscheinen. Wichtig: 6,13 Punkte sind nicht automatisch 6,13 Prozent höhere Genauigkeit und erst recht kein Gewinn von 6,13 Prozentpunkten bei allen Unternehmensaufgaben.
In einem weiteren, etwa neunstündigen Lauf richtete das Team die Optimierung auf Effizienz aus. Salesforce berichtet dort 36 Prozent mehr Durchsatz und 17 Prozent niedrigere Latenz, bei nahezu unveränderter Retrieval-Qualität. Diese Werte gehören zu einem anderen Optimierungsziel und dürfen nicht zu einer einzigen, allgemein garantierten Verbesserung addiert werden. Die Vergleichsbedingungen, Rechenkosten und Reproduzierbarkeit müssen für eine belastbare Wirtschaftlichkeitsentscheidung gesondert geprüft werden.
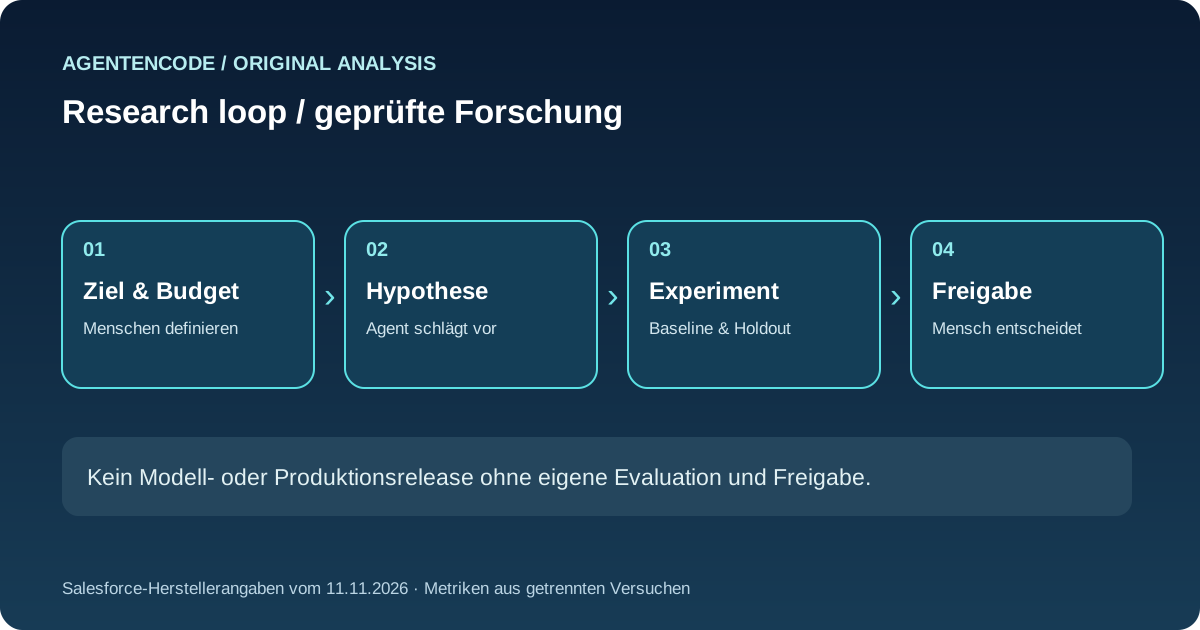
4. Wie aus einem Forschungsvorschlag eine belegte Änderung wird
Der entscheidende Unterschied zu „Agent schreibt Training-Code“ liegt in einer geschlossenen, aber kontrollierten Evaluationsschleife. Zuerst wird eine Hypothese formuliert; anschließend werden Code, Trainingskonfiguration und Messverfahren festgehalten. Die neue Variante tritt auf zurückgehaltenen Evaluationsdaten gegen die Baseline an. Nur wenn die vorab festgelegten Kriterien erfüllt sind, wird die Änderung als Kandidat übernommen.
Die Schleife kann viele Versuche schneller organisieren als ein rein manueller Forschungsprozess. Sie verschiebt die Verantwortung aber nicht automatisch von Menschen auf Software. Wer die Metrik auswählt, legt fest, was das System optimiert. Ein Modell kann auf Benchmarks besser werden und zugleich etwa bei seltenen Sprachen, regulierten Dokumenten oder bislang unbekannten Kundenfragen versagen. Schutz vor Benchmark-Überanpassung, Datenleckagen und unvollständiger Messung gehört daher zum eigentlichen Produktdesign.
5. Was „autonome Forschung“ in diesem Fall bedeutet – und was nicht
Salesforce spricht von eigenständig formulierten Hypothesen und durchgeführten Experimenten. Das belegt im beschriebenen Rahmen eine bemerkenswerte Automatisierung des Forschungsworkflows. Es belegt nicht, dass das System die Forschungsfrage selbst gewählt, ethische Datennutzung selbst entschieden oder jede Änderung unbeaufsichtigt in Produktion geschaltet hat. Laut Salesforce geben Forschende Ziele, Budget, Datenregeln und Evaluationsmaßstäbe vor. Für den Kundeneinsatz gelten darüber hinaus Freigabeanforderungen.
SFR-AutoR&D wurde nach Herstellerangaben eingesetzt, um die bestehende Embedding-Familie zu verbessern; Salesforce beschreibt außerdem die Entwicklung einer neuen Modellvariante ausgehend von EmbeddingGemma 2. Das darf nicht mit der Behauptung verwechselt werden, jede genannte Variante sei bereits für alle Kunden ausgerollt. Der Artikel vom 11. November beschreibt weitere Produktionsfreigaben als laufende Arbeit.
6. AgentenCode-Prüfmatrix für einen reproduzierbaren Pilotversuch
Ein Unternehmen, das diesen Ansatz übernehmen möchte, sollte zunächst eine eng definierte, wiederholbare Optimierungsaufgabe wählen. Vor dem ersten Lauf müssen eine eingefrorene Baseline, ein unveränderter Testdatensatz, die zulässigen Datenquellen, maximale Rechenzeit und eine menschliche Freigabestelle feststehen. Danach sollten nicht nur ein einzelner Bestwert, sondern mehrere Läufe mit Streuung, sämtliche Experimentkosten und Regressionen nach Segment ausgewertet werden.
| Prüfpunkt | Darauf achten | Warnsignal |
|---|---|---|
| Qualität | Vergleich auf festen Testdaten; nDCG@10 und Aufgaben aus der Praxis | Nur Werte aus der Entwicklung |
| Tempo | Durchsatz und Latenz unter identischen Bedingungen | Unterschiedliche Hardware oder Last |
| Sicherheit | Datenquellen prüfen; Code-Review und Rückweg vorsehen | Änderungen ohne Freigabe |
| Kosten | Rechenzeit, Fehlversuche und menschliche Arbeit einrechnen | Nur der schnellste Lauf wird gezeigt |
| Wiederholbarkeit | Mehrere Versuche mit dokumentierten Versionen | Keine Artefakte oder nur ein Bestlauf |
Diese Kriterien sind eine redaktionelle Entscheidungshilfe, keine von Salesforce zertifizierte Prüfnorm.
7. Offene Fragen bei Kosten, Generalisierung und Governance
Die größere Unsicherheit liegt nicht beim Bericht über einzelne Metriken, sondern bei ihrer Übertragbarkeit. Wie viele erfolglose Versuche waren erforderlich? Welche Daten oder vorbereiteten Werkzeuge standen den Agenten zur Verfügung? Wie viel Rechenleistung wurde während der rund 80 Stunden verbraucht? Wie zuverlässig sind die Resultate bei anderen Domänen, Sprachen und Dokumentenarten? Die veröffentlichte Meldung beantwortet diese Fragen nicht vollständig.
Autonome Experimentagenten benötigen zudem besonders strikte Grenzen. Schreibzugriffe auf Trainingspipelines, Datenbestände oder Produktionsmodelle dürfen nicht aus einer erfolgreichen Benchmarkverbesserung folgen. Eine unabhängige Produktionsfreigabe sollte weiterhin prüfen, ob sich das neue Modell gegen Angriffe, Datenvergiftung und unerwünschte Nebeneffekte behauptet.
8. AgentenCode-Bewertung: Ein belastbares Muster statt einer Forschungsrevolution auf Knopfdruck
Unsere Einordnung: SFR-AutoR&D ist interessant, weil die Agentenarbeit an überprüfbare Messungen gebunden wird. Nicht die Behauptung voller Autonomie schafft Vertrauen, sondern der dokumentierte Weg von Hypothese über Experiment und Holdout-Test zu einer menschlich verantworteten Freigabe. Genau hier kann ein nachhaltiger Burggraben für agentische Forschung entstehen: hochwertige Evaluationssets, Experimenthistorie und reproduzierbare Entscheidungen statt bloß immer neuer Agenten.
Für Teams mit stabilen Retrieval-Aufgaben, ausreichender ML-Infrastruktur und guten Tests lohnt sich ein begrenzter Pilot. Für Organisationen ohne kontrollierte Datenbasis und eigenes Evaluationsverfahren wäre die direkte Übernahme der Autonomie deutlich zu früh. Die Verbesserung eines Retrievalmodells ist nicht gleichbedeutend mit der autonomen Durchführung allgemeiner wissenschaftlicher Forschung.
Häufige Fragen
Hat Salesforce ein vollständig selbstforschendes KI-System veröffentlicht?
Nein. Es handelt sich um ein agentisches System für vorgegebene Forschungsziele und Evaluationsverfahren. Menschen bestimmen Grenzen und Freigaben.
Sind 6,13 Punkte nDCG@10 eine Genauigkeitssteigerung von 6,13 Prozent?
Nein. Die Metrik misst die Rangqualität der Trefferliste. Ihr Punktegewinn ist nicht automatisch ein Prozentwert oder ein End-to-End-Ergebnis.
Sind 36 Prozent Durchsatzgewinn und 17 Prozent weniger Latenz allgemeingültig?
Nein. Das sind Ergebnisse eines getrennten, von Salesforce beschriebenen Optimierungslaufs mit bestimmten Vergleichsbedingungen.
Kann ein Unternehmen diese Verbesserungen unmittelbar übernehmen?
Nicht ohne eigene Tests und Klärung der tatsächlichen Modellverfügbarkeit. Die Meldung beschreibt Forschungs- und Produktionsarbeiten, keinen universell garantierten Rollout.
Primärquelle und Evidenzstatus
- Salesforce AI Research: „Salesforce Releases R&D Agents That Improve Its AI Models“, 11.11.2026
- Evidenz: Herstellerbericht mit konkreten Metriken; keine hier durchgeführte unabhängige Reproduktion. Recherche- und Entwurfsstand: 12.11.2026. Redaktionelle Entscheidungsregeln sind als AgentenCode-Einordnung ausgewiesen.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Für diesen Artikel haben wir die folgenden Originalveröffentlichungen und technischen Unterlagen ausgewertet. Die Quellen kannst du direkt öffnen.
Herstellerangaben und veröffentlichte Leistungswerte sind keine eigenen Praxistests; wir haben sie nicht unabhängig nachgemessen.