
Stanford Memorilla: Ein KI-Gedächtnis merkt sich ganze Archive mit nur 16 Tokens
Memorilla komprimiert große Dokumentbestände in 16 lernbare Gedächtnis-Tokens für LLMs. Was 4.000-fache Kompression, Benchmarks und Grenzen bedeuten.
Ein KI-Gedächtnis statt eines immer längeren Chats
Warum vergessen Sprachmodelle wichtige Einzelheiten, obwohl ihre Kontextfenster größer werden? Lange Gesprächsverläufe und Dokumentenbestände kosten Rechenzeit; eine reine Suche kann relevante Hinweise übersehen, wenn sie nicht dieselben Wörter wie die Frage enthalten. Memorilla vom Stanford-SNAP-Umfeld schlägt einen anderen Weg vor: Ein kleines trainierbares Modul liest viele gespeicherte Dokumentdarstellungen und erzeugt nur die gerade benötigten Gedächtnis-Tokens.
Die wissenschaftliche Vorveröffentlichung stammt bereits vom Oktober 2026. Hochaktuell ist die Diskussion über den inzwischen öffentlich zugänglichen Code, Gewichte und die jüngsten offenen Auswertungen im November. Das ist kein plötzlich neu erfundenes Gedächtnis und keine Ankündigung eines kommerziellen Verbraucherdienstes.
16 Tokens für einen ganzen Dokumentenbestand?
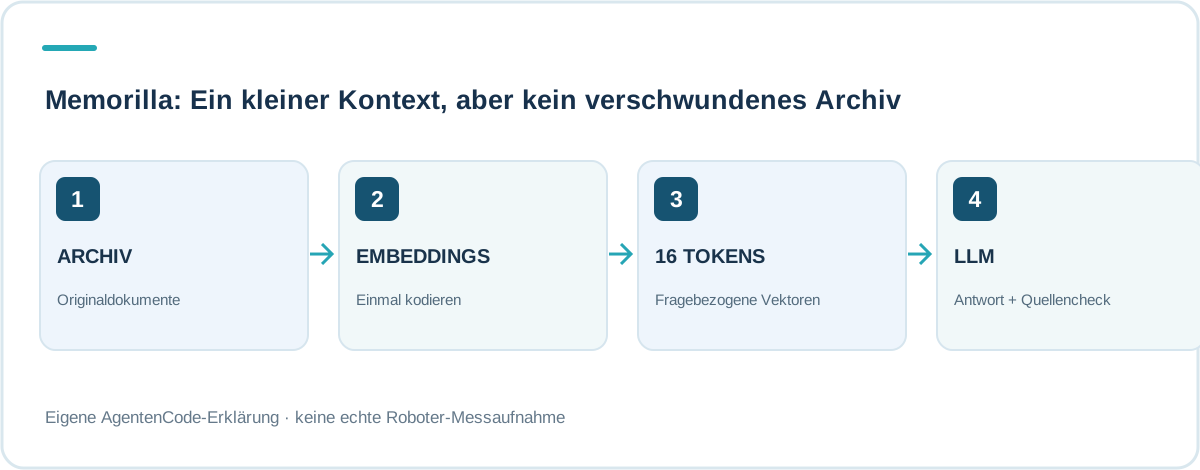
Die Architektur kodiert Dokumente zunächst einmal mit einem festen Embedding-Modell und speichert ihre Vektoren. Bei einer neuen Frage lesen gelernte Memory Slots den gesamten Vektorbestand, passen ihren Fokus an die Frage an und geben 16 kontinuierliche Memory Tokens in den Eingaberaum eines ebenfalls nicht nachtrainierten Sprachmodells. Das unterscheidet den Ansatz von klassischer RAG-Suche, die ausgewählte Textpassagen in die Anfrage kopiert.
Wichtig ist der Begriff Token: Es sind keine 16 gewöhnlichen Wörter und auch keine verlustfreien Archivdateien. Das Modul berechnet für jede Frage 16 interne Vektoren; der Speicher der Dokument-Embeddings existiert weiterhin. Die extreme Verdichtung betrifft die Informationen, die dem Antwortmodell unmittelbar als Kontext übergeben werden – nicht die Größe des ursprünglichen Archivs.
84,33 Prozent statt 80,43 – trotz kürzerem Kontext
Auf FactKG meldet das Forschungsteam 84,33 Prozent Genauigkeit gegenüber 80,43 Prozent für dieselbe Qwen3-8B-Basis mit dem vollständigen Dokumentkontext. Dafür benötigt Memorilla nach Angaben der Autoren 108-mal weniger Dokument-Tokens im direkten Prompt. Auf fünf von acht evaluierten Benchmarks führt das Verfahren laut Paper im Vergleich zu den gewählten Baselines.
Ein anderes Experiment nennt mehr als 4.000-fache Dokument-Token-Kompression auf NarrativeQA. Diese Extremzahl ist auf einen bestimmten Vergleich und Datensatz begrenzt: Sie darf nicht als allgemeine Garantie verstanden werden, dass jeder Text bei 4.000-facher Kompression fehlerfrei abrufbar bleibt. Auch die Genauigkeitswerte wurden nicht von AgentenCode unabhängig reproduziert.
Schneller, aber nicht ohne Vorarbeit
Die Projektseite nennt bei 512 Dokumenten und einem H100-80GB eine Antwortzeit von ungefähr 0,74 Sekunden gegenüber 19,9 Sekunden, wenn der gesamte Kontext bei jeder Frage mitverarbeitet wird. Das ergibt in dieser Versuchsanordnung etwa den Faktor 27. Die Speicherembeddings müssen zuvor berechnet werden und die trainierbare Memory-Schicht muss vorbereitet sein.
Solche Messungen sind nicht eins zu eins mit einer gut optimierten RAG-Lösung vergleichbar. Auch Hardwarekosten, Indexierung, Aktualisierungen und die Anzahl paralleler Anfragen zählen. Die Vorführkonfiguration verwendet CUDA-GPUs, Python 3.11 und Qwen-basierte Encoder und Decoder; für eine einfache CPU-App liegt kein gleichwertiger Nachweis vor.
Interessant für persönliche Assistenten und Agenten
Ein Agent, der über Monate Aufgaben bearbeitet, muss alte Entscheidungen, Einschränkungen und gescheiterte Wege wiederfinden. Das Memorilla-Paper beschreibt dafür Experimente in TextWorld: Mit acht Memory Tokens stieg die mittlere Erfolgsquote von 18,6 auf 24,2 Prozent gegenüber einem Agenten, der seinen gesamten bisherigen Verlauf im Kontext erhielt.
Das ist eine relative Verbesserung in einer simulierten Textwelt, kein Beweis, dass ein realer Assistent zuverlässig alle Vorlieben oder Aufgaben kennt. Das Gedächtnis kann Fehler, veraltete Aussagen oder unberechtigte Informationen ebenso verdichten wie brauchbares Wissen. Für Multi-Agenten-Systeme ist kontrollierbare Löschung und Trennung von Benutzerkontext besonders wichtig.
Woran diese Gedächtnisform scheitern kann
Eine starke Kompression kann feine Details vernichten: exakte Formulierungen, seltene Zahlen oder eine Quelle, die für eine juristische oder wissenschaftliche Antwort zwingend ist. Das Paper nennt auch Aufgaben, bei denen andere Verfahren besser abschneiden, darunter medizinische Frage-Antwort-Datensätze und einzelne Langtext-Benchmarks.
Memorilla ist kein Ersatz für Belegstellen. Anwendungen, die überprüfbare Zitate oder identische Vertragssätze benötigen, sollten im Originaltext nachsehen. Eine Kombination mit dokumentenbasierter Suche kann sinnvoller sein als ein alleiniger Latentspeicher. Das ist besonders entscheidend, wenn eine Entscheidung rechtliche, medizinische oder finanzielle Folgen haben könnte.
Die Gewichte bleiben unverändert, der Speicher lernt
Beim offen veröffentlichten Forschungsprojekt werden ein fester Qwen3-Embedding-4B-Encoder und ein fester Qwen3-8B-Antwortdecoder mit einem zusätzlichen Modul von rund 194 Millionen trainierbaren Parametern kombiniert. Neue Dokumente können einzeln eingebettet werden; das gesamte Sprachmodell muss für zusätzliche Erinnerungen nicht vollständig weitertrainiert werden.
Der Code samt Trainings- und Evaluationsrezepten wird offen angeboten. Trotzdem braucht die Referenzumgebung leistungsfähige Beschleuniger und eine saubere Datenverwaltung. Wer persönliche Konversationen speichert, muss Löschanforderungen, Berechtigungen und die Herkunft jeder Information auch außerhalb des Modells organisieren.
AgentenCode-Einordnung: Weniger Kontext, gezielteres Erinnern
Memorilla zeigt einen möglicherweise bedeutenden Richtungswechsel: Nicht immer größere Kontextfenster, sondern gezielt trainierte, kompakte Langzeitgedächtnisse können bestimmte Aufgaben günstiger und genauer machen. Der spannendste Teil ist, dass das Antwortmodell unverändert bleibt und dennoch aus einem ständig wachsenden Dokumentenbestand schöpft.
Die Ergebnisse sind datensatz- und hardwareabhängig, und extreme Kompression verlangt starke Qualitätskontrollen. Für seriöse Anwendungen würden wir Erinnerungsgenauigkeit über Zeit, verlorene Details, unveränderliche Quellenverweise und eine verlässliche Löschung prüfen. Das ist spannende offene Forschung, noch kein magisches Gedächtnis ohne Vergessen.
Häufige Fragen
Kann Memorilla tatsächlich ein ganzes Archiv in 16 Wörter speichern?
Nein. Es erstellt 16 interne, frageabhängige Vektor-Tokens, während Dokument-Embeddings im externen Speicher verbleiben.
Ist die Forschung vom 15. November 2026?
Nein. Das Paper erschien erstmals im Oktober; die offene Implementierung und die breitere Berichterstattung sind im November aktuell.
Muss das Sprachmodell neu trainiert werden?
In den beschriebenen Experimenten bleiben Encoder und Qwen3-8B-Decoder eingefroren; trainiert wird ein kleineres zusätzliches Memory-Modul.
Kann das die RAG-Suche ersetzen?
Bei manchen Aufgaben kann es den Kontext verkürzen, für genaue Zitate und kontrollierbare Originalquellen ist RAG beziehungsweise direkte Nachsuche weiterhin wichtig.
RECHERCHE & EINORDNUNG
Quellen zu diesem Artikel
Die folgenden Originalveröffentlichungen bilden die Grundlage dieser Analyse. Sie sind direkt nachprüfbar.
- Stanford – Memorilla project and release resources
- Memorilla research paper, arXiv:2610.21375 (first posted October 2026)
- Stanford SNAP – Open training and inference implementation
- Memorilla – PersonalizationV4 research benchmark and attribution
Stand: 15. November 2026. Herstellerangaben, Rollout und Preview-Funktionen sind nicht unabhängig verifiziert; keine eigene Sicherheitszertifizierung.